Cloisonné par espace
Organisation, projet, dossier, corpus : chaque espace a ses documents et ses droits. Une clé API ne voit que ce que vous lui avez ouvert.
RAG · Connaissance structurée · Flocon · MCP
Ts-Knowledge indexe vos documents pour que votre IA y retrouve le bon passage, en extrait les personnes, les faits, les relations et les événements — chacun avec sa preuve — et met le tout à la disposition de Claude, ChatGPT, Gemini ou Mistral par un serveur MCP.
Aucun LLM imposé. Votre corpus reste chez vous, vos clés de modèle aussi.
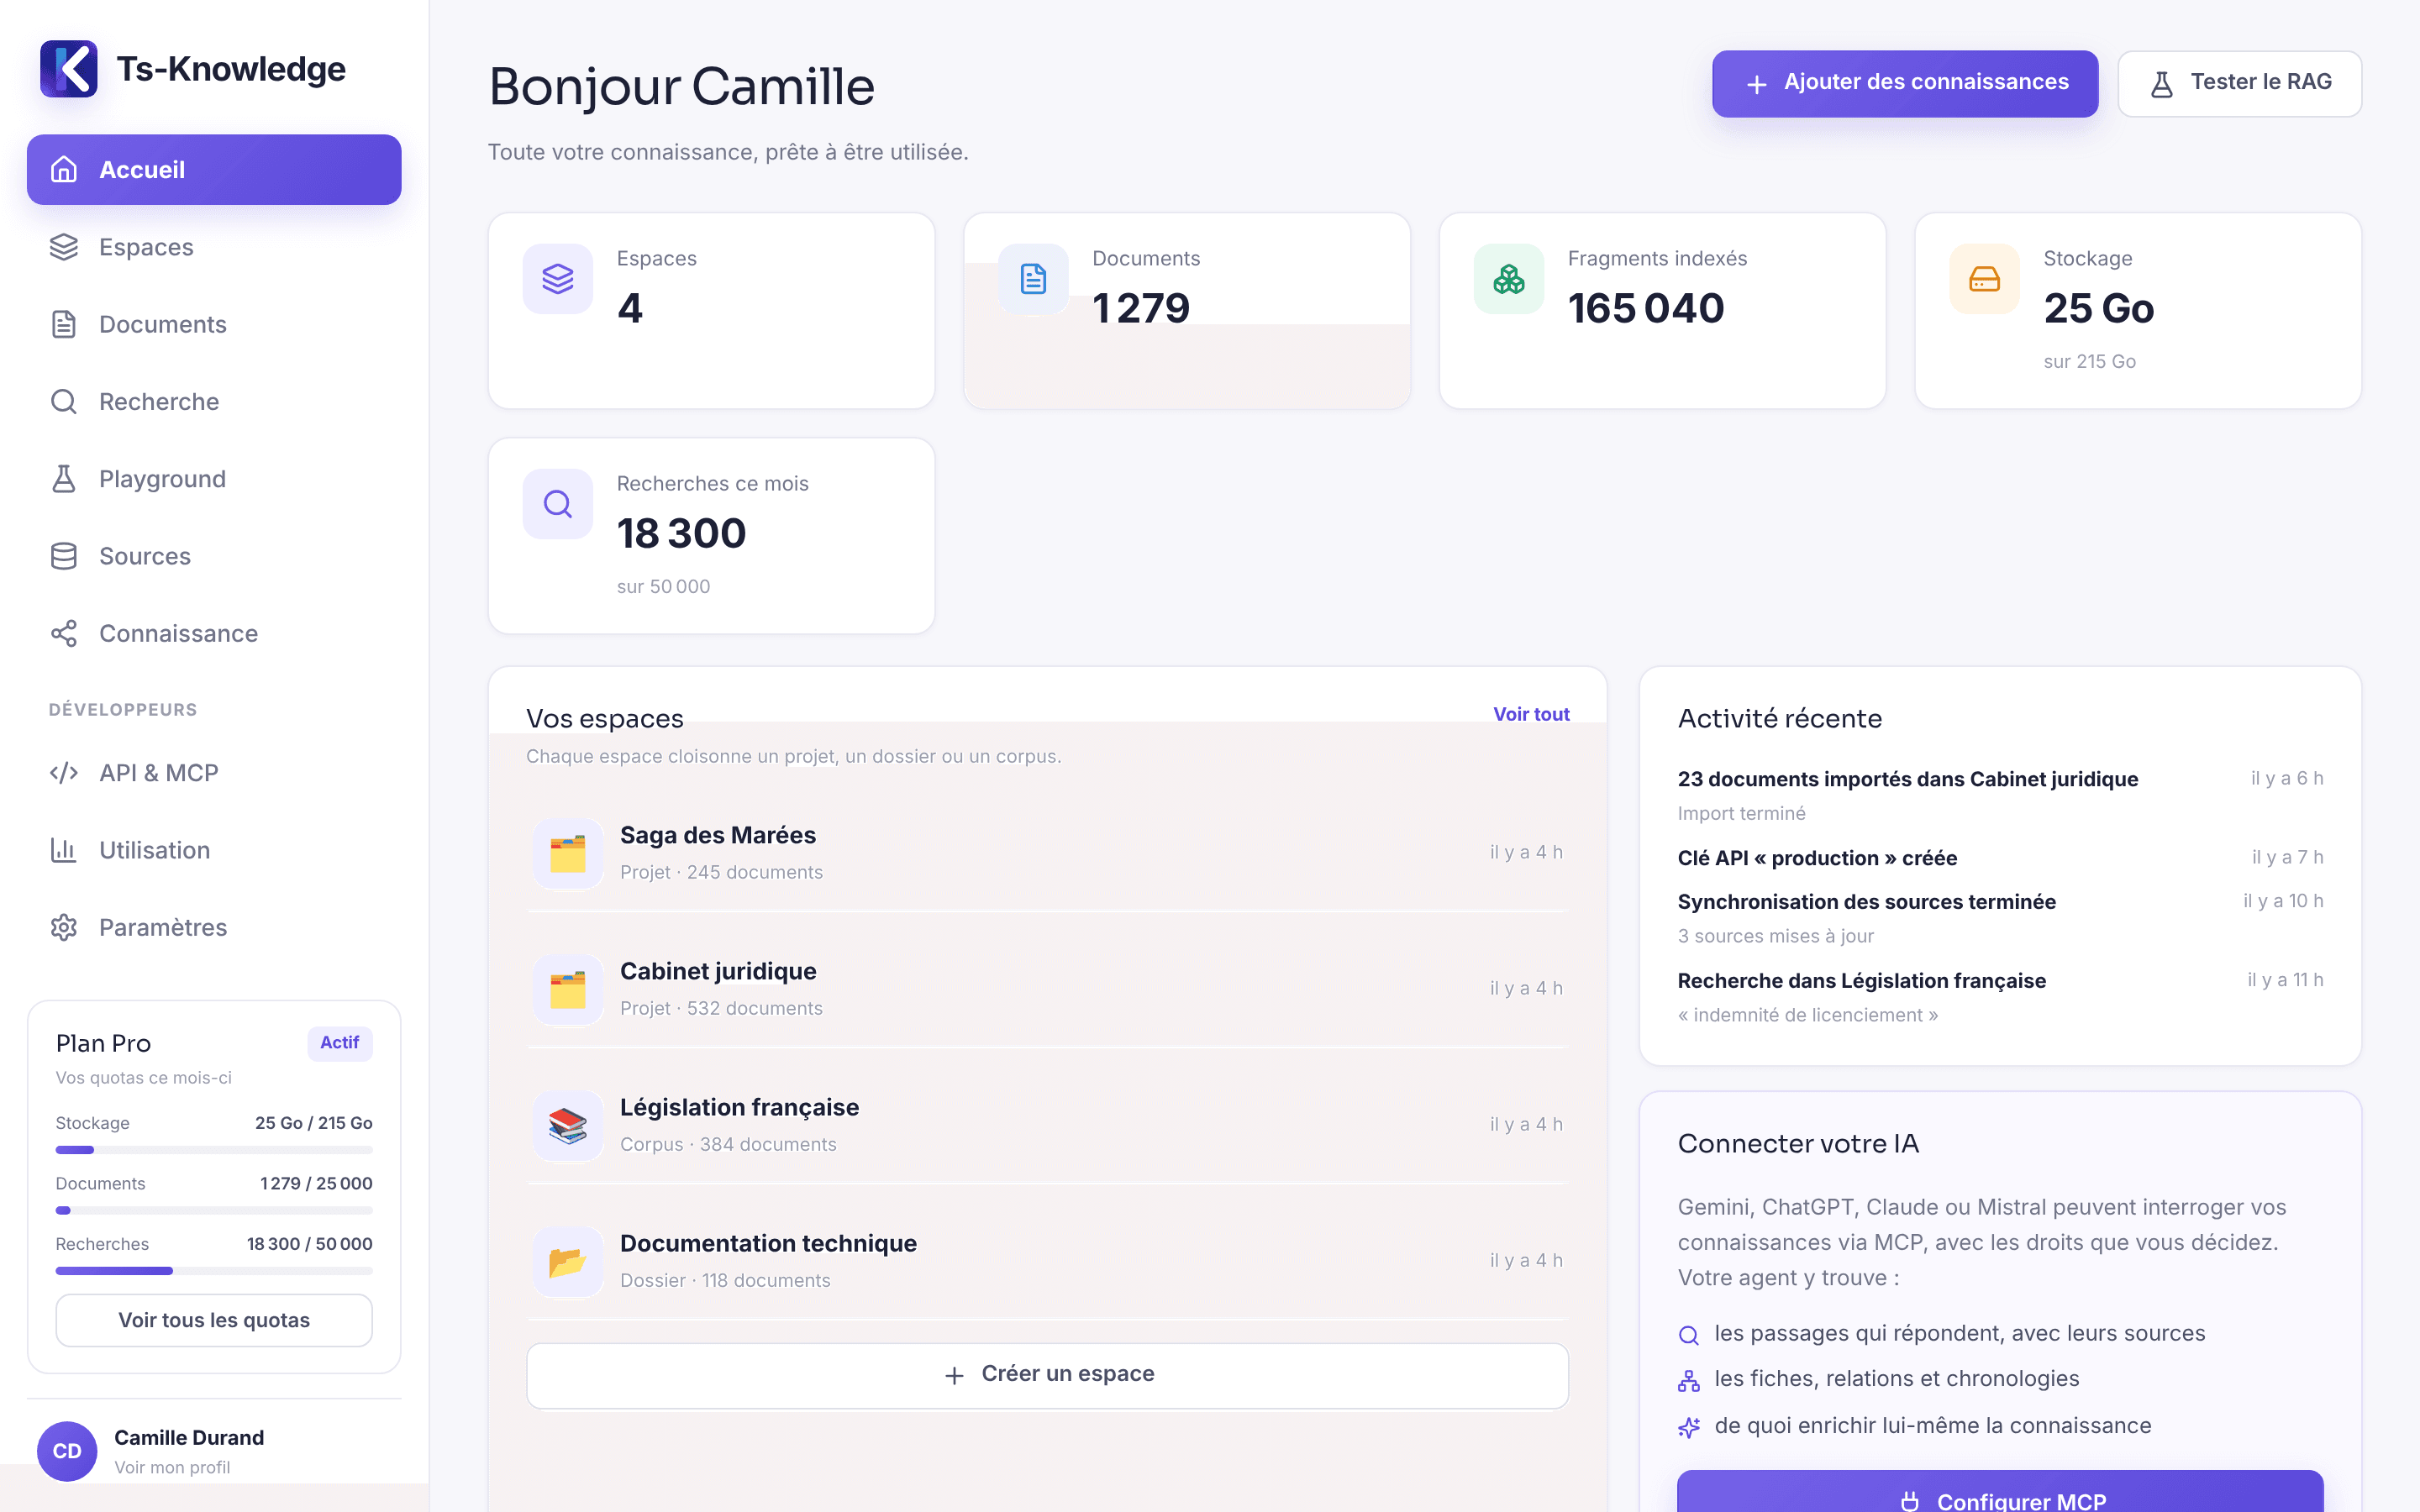
Ce n'est pas un chatbot de plus. Ts-Knowledge fait le travail que votre IA ne peut pas faire seule : savoir ce que contiennent vos documents, le prouver, et le lui servir avec les droits que vous avez fixés. La rédaction de la réponse appartient à l'IA que vous avez déjà choisie.
1 · Retrouver
Le socle du produit : retrouver le bon passage, et pouvoir dire d'où il vient.
Organisation, projet, dossier, corpus : chaque espace a ses documents et ses droits. Une clé API ne voit que ce que vous lui avez ouvert.
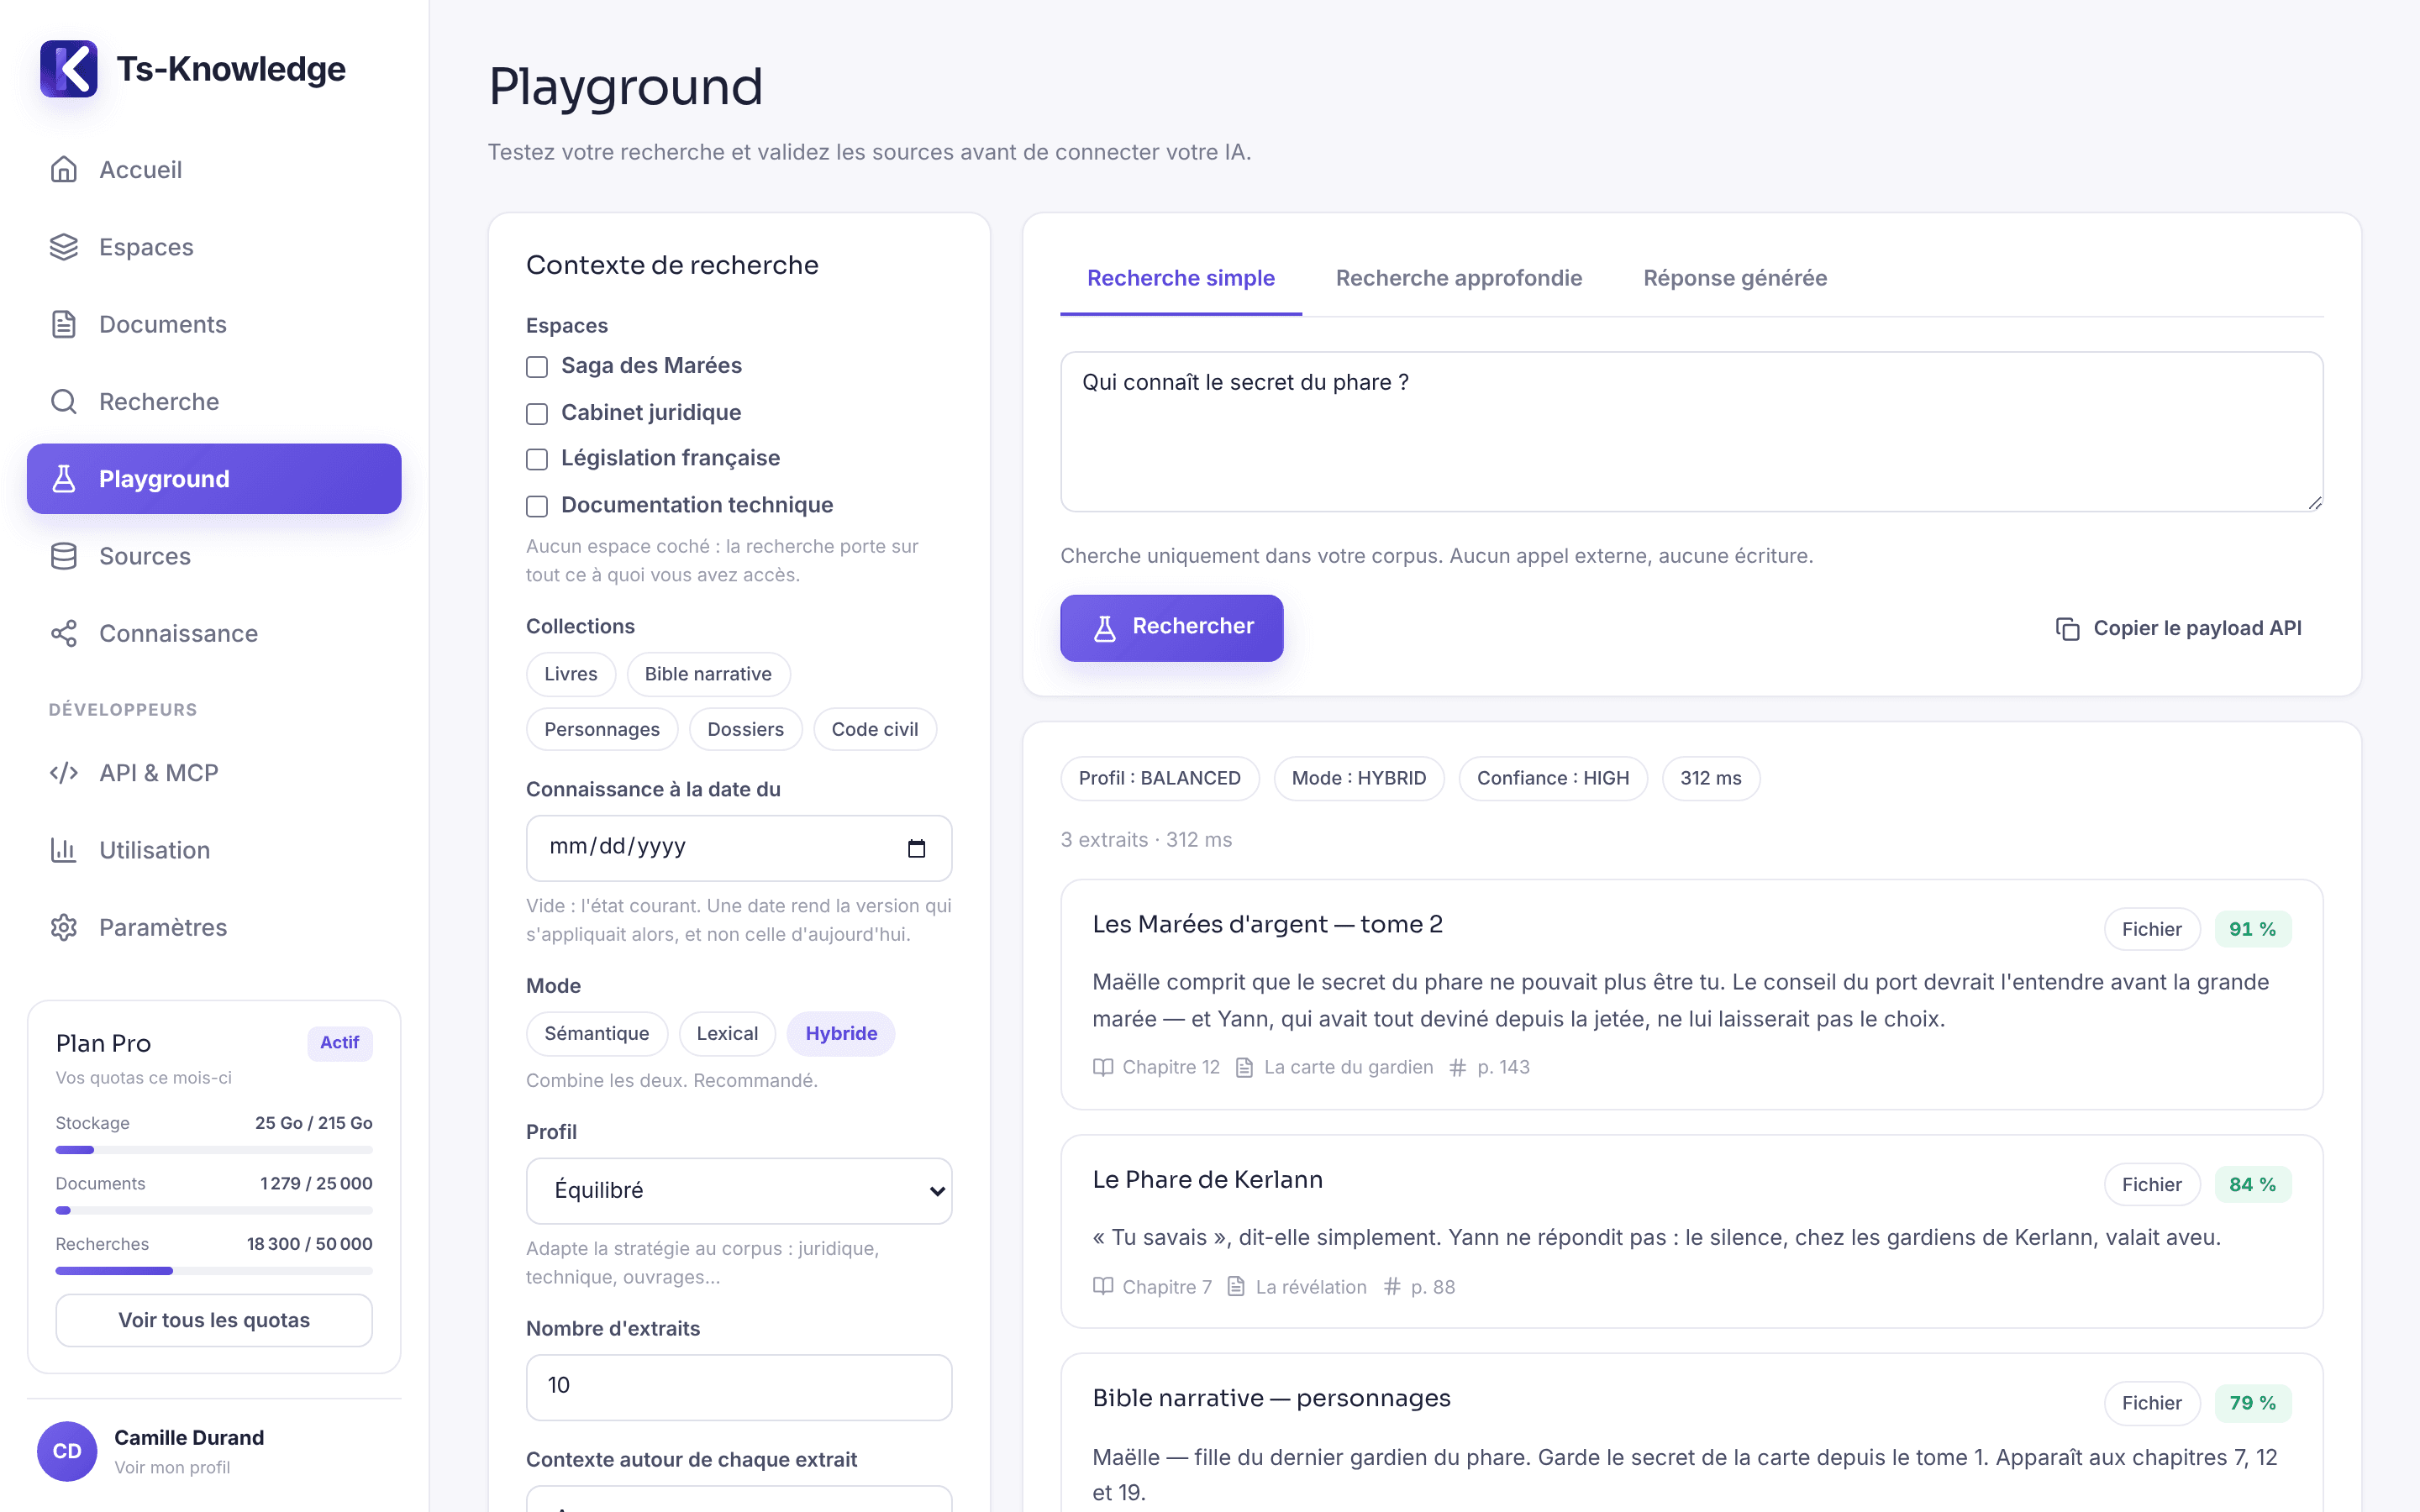
Le sens et les mots exacts, fusionnés : une question en langage naturel comme un numéro d'article trouvent leur passage.
Titre, chapitre, page, article, URL source : chaque extrait arrive avec de quoi le vérifier, pas seulement du texte concaténé.
La pertinence est mesurée, pas déduite d'un rang : elle se compare d'une recherche à l'autre, et se seuille côté client.
Quand le corpus ne contient pas la réponse, il le signale au lieu de rendre ses plus proches voisins — c'est ce qui évite à votre agent de broder.
PDF, DOCX, Markdown, HTML, texte — découpés en respectant chapitres, articles et paragraphes, jamais au milieu d'une phrase.
Le Playground montre le retrieval brut : les passages retenus, leur pertinence, leur citation — chapitre, section, page. Avant de brancher un agent, vous savez déjà si votre corpus répond.
2 · Comprendre
Une recherche rend des passages. Certaines questions demandent plus : quels personnages connaissent le secret ?, dans quel ordre les événements du tome 2 se sont-ils produits ?, où deux chapitres se contredisent-ils ? Ts-Knowledge lit vos documents et en tire ce qu'ils affirment — entités, faits, relations, événements — en gardant pour chacun le passage qui le prouve. Une seconde couche, dérivée du corpus, qui s'ajoute à la recherche sans jamais la remplacer.
Un personnage, un lieu, un service, une partie à un dossier : la fiche réunit ce que vos documents en disent, rangé par thème, avec le nombre de passages qui soutiennent chaque valeur.
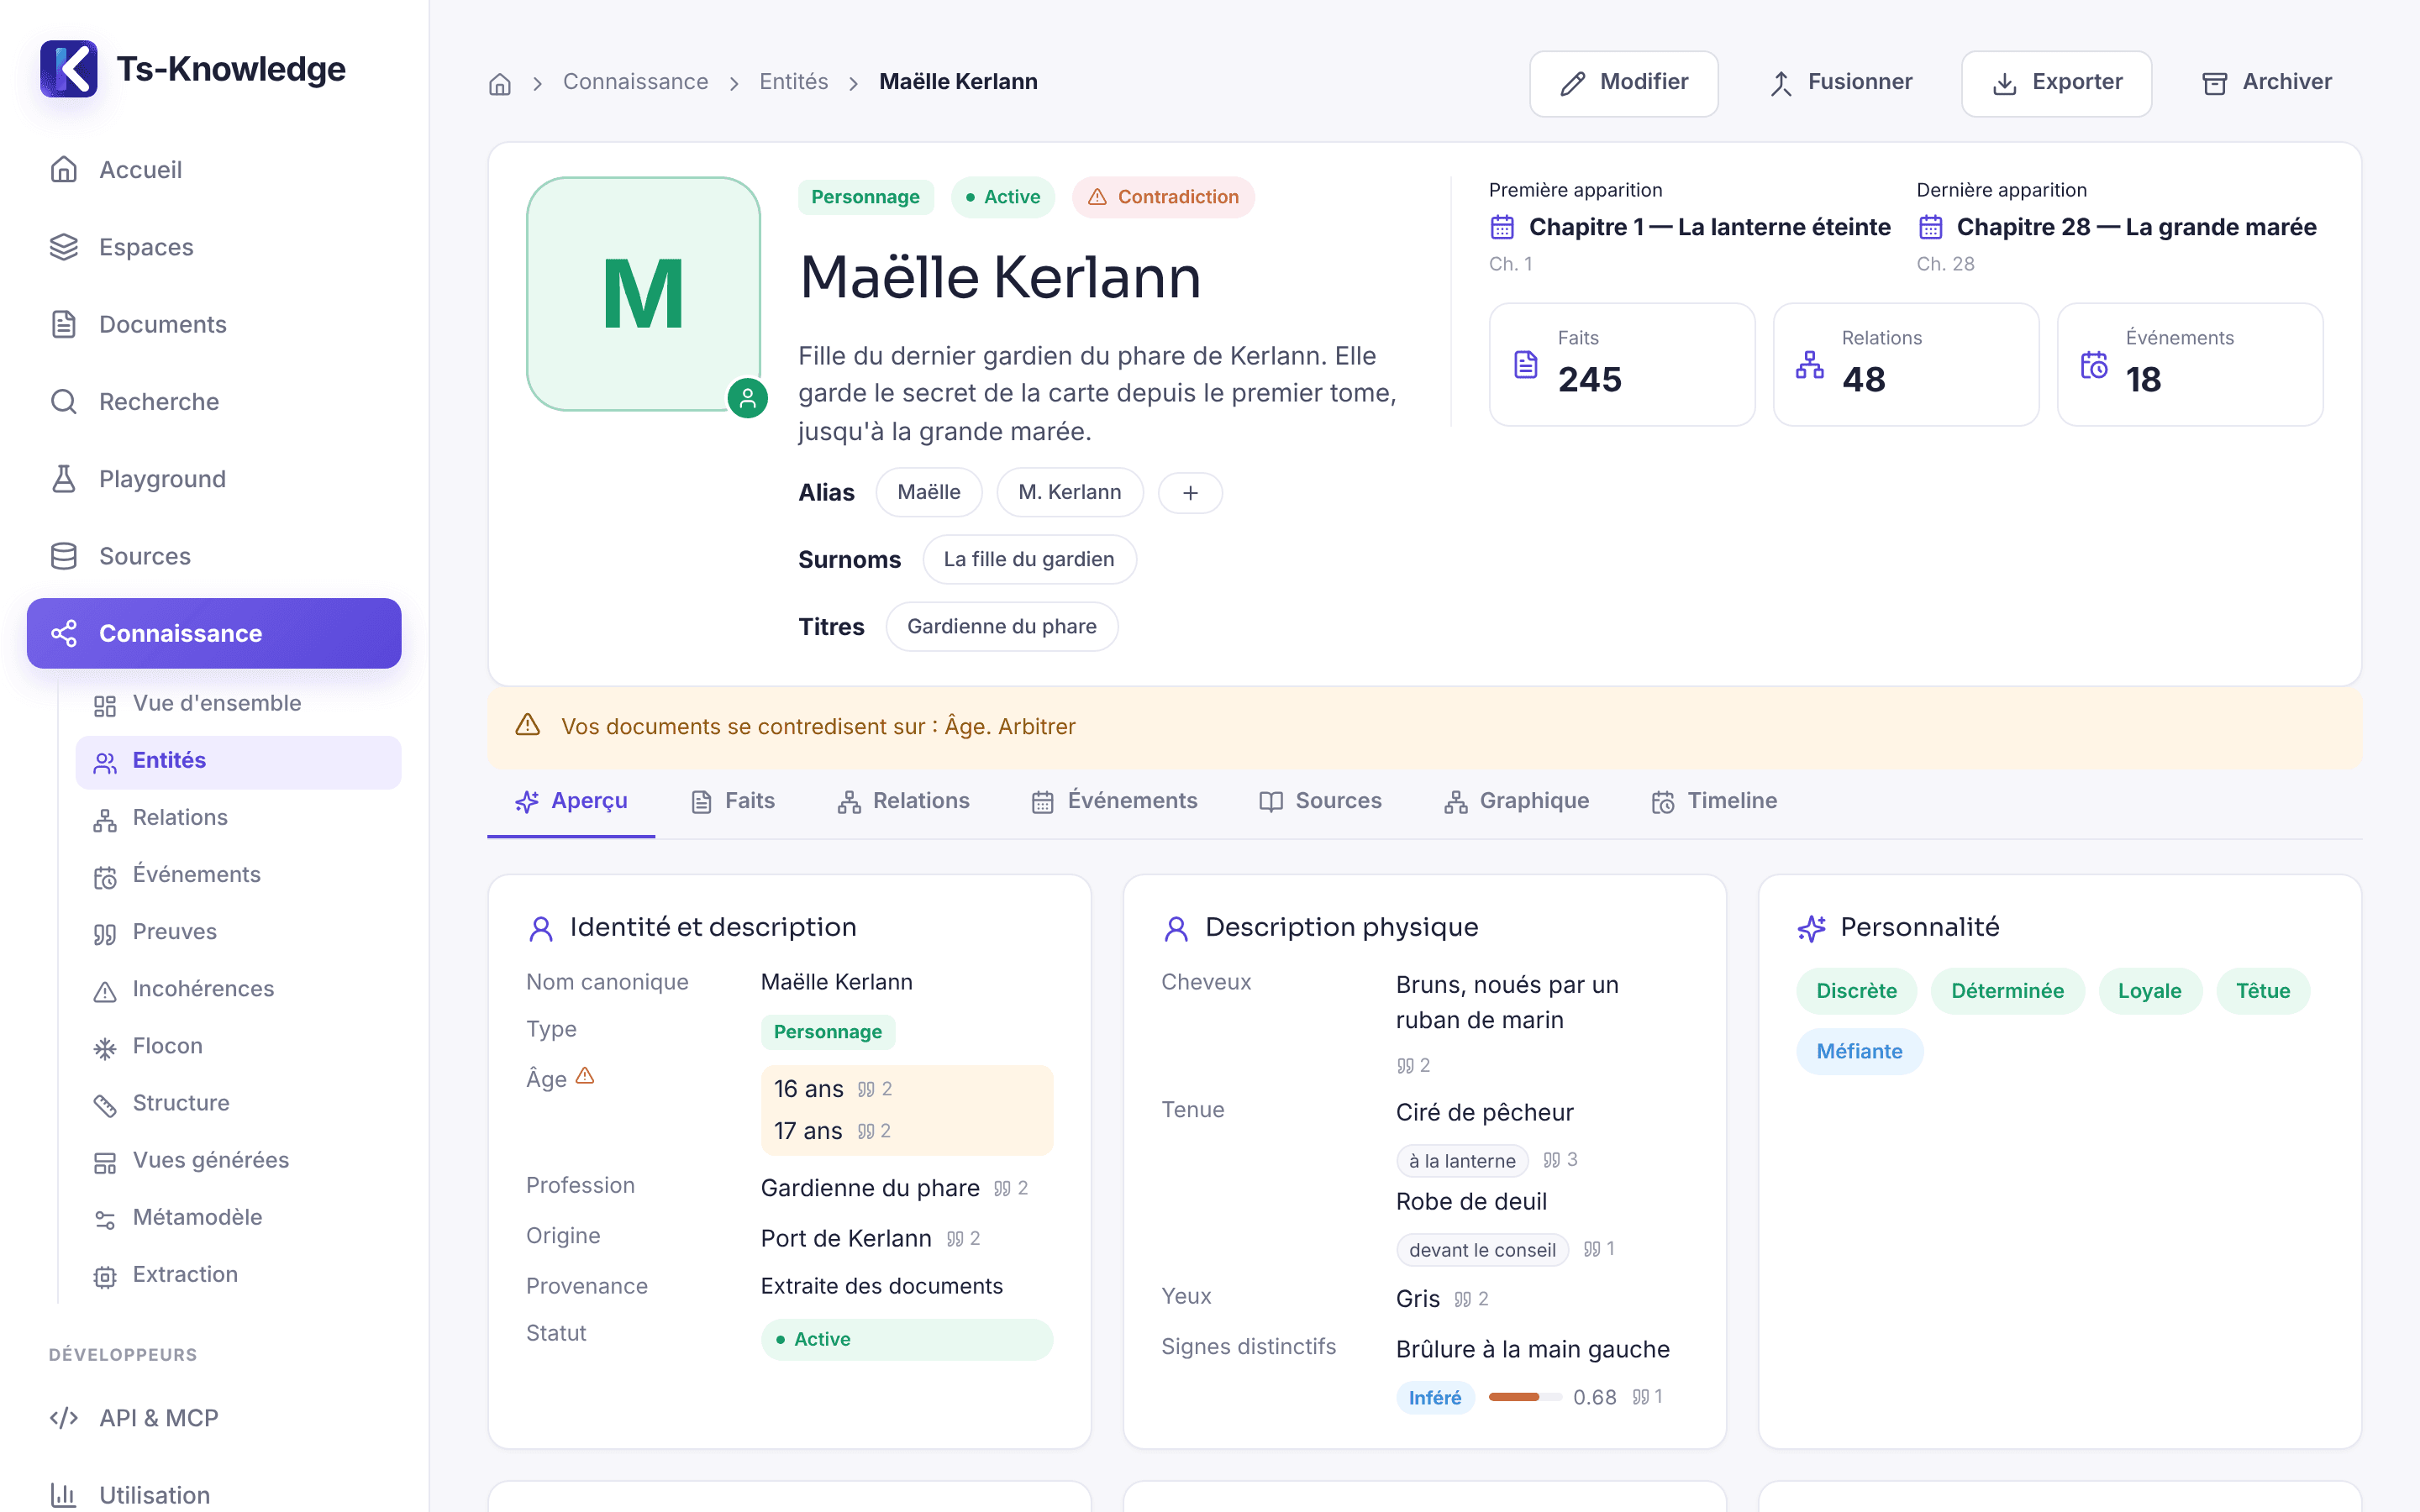
Personnages, lieux, organisations, objets — ou ce que votre métier appelle ainsi : le vocabulaire se règle par espace.
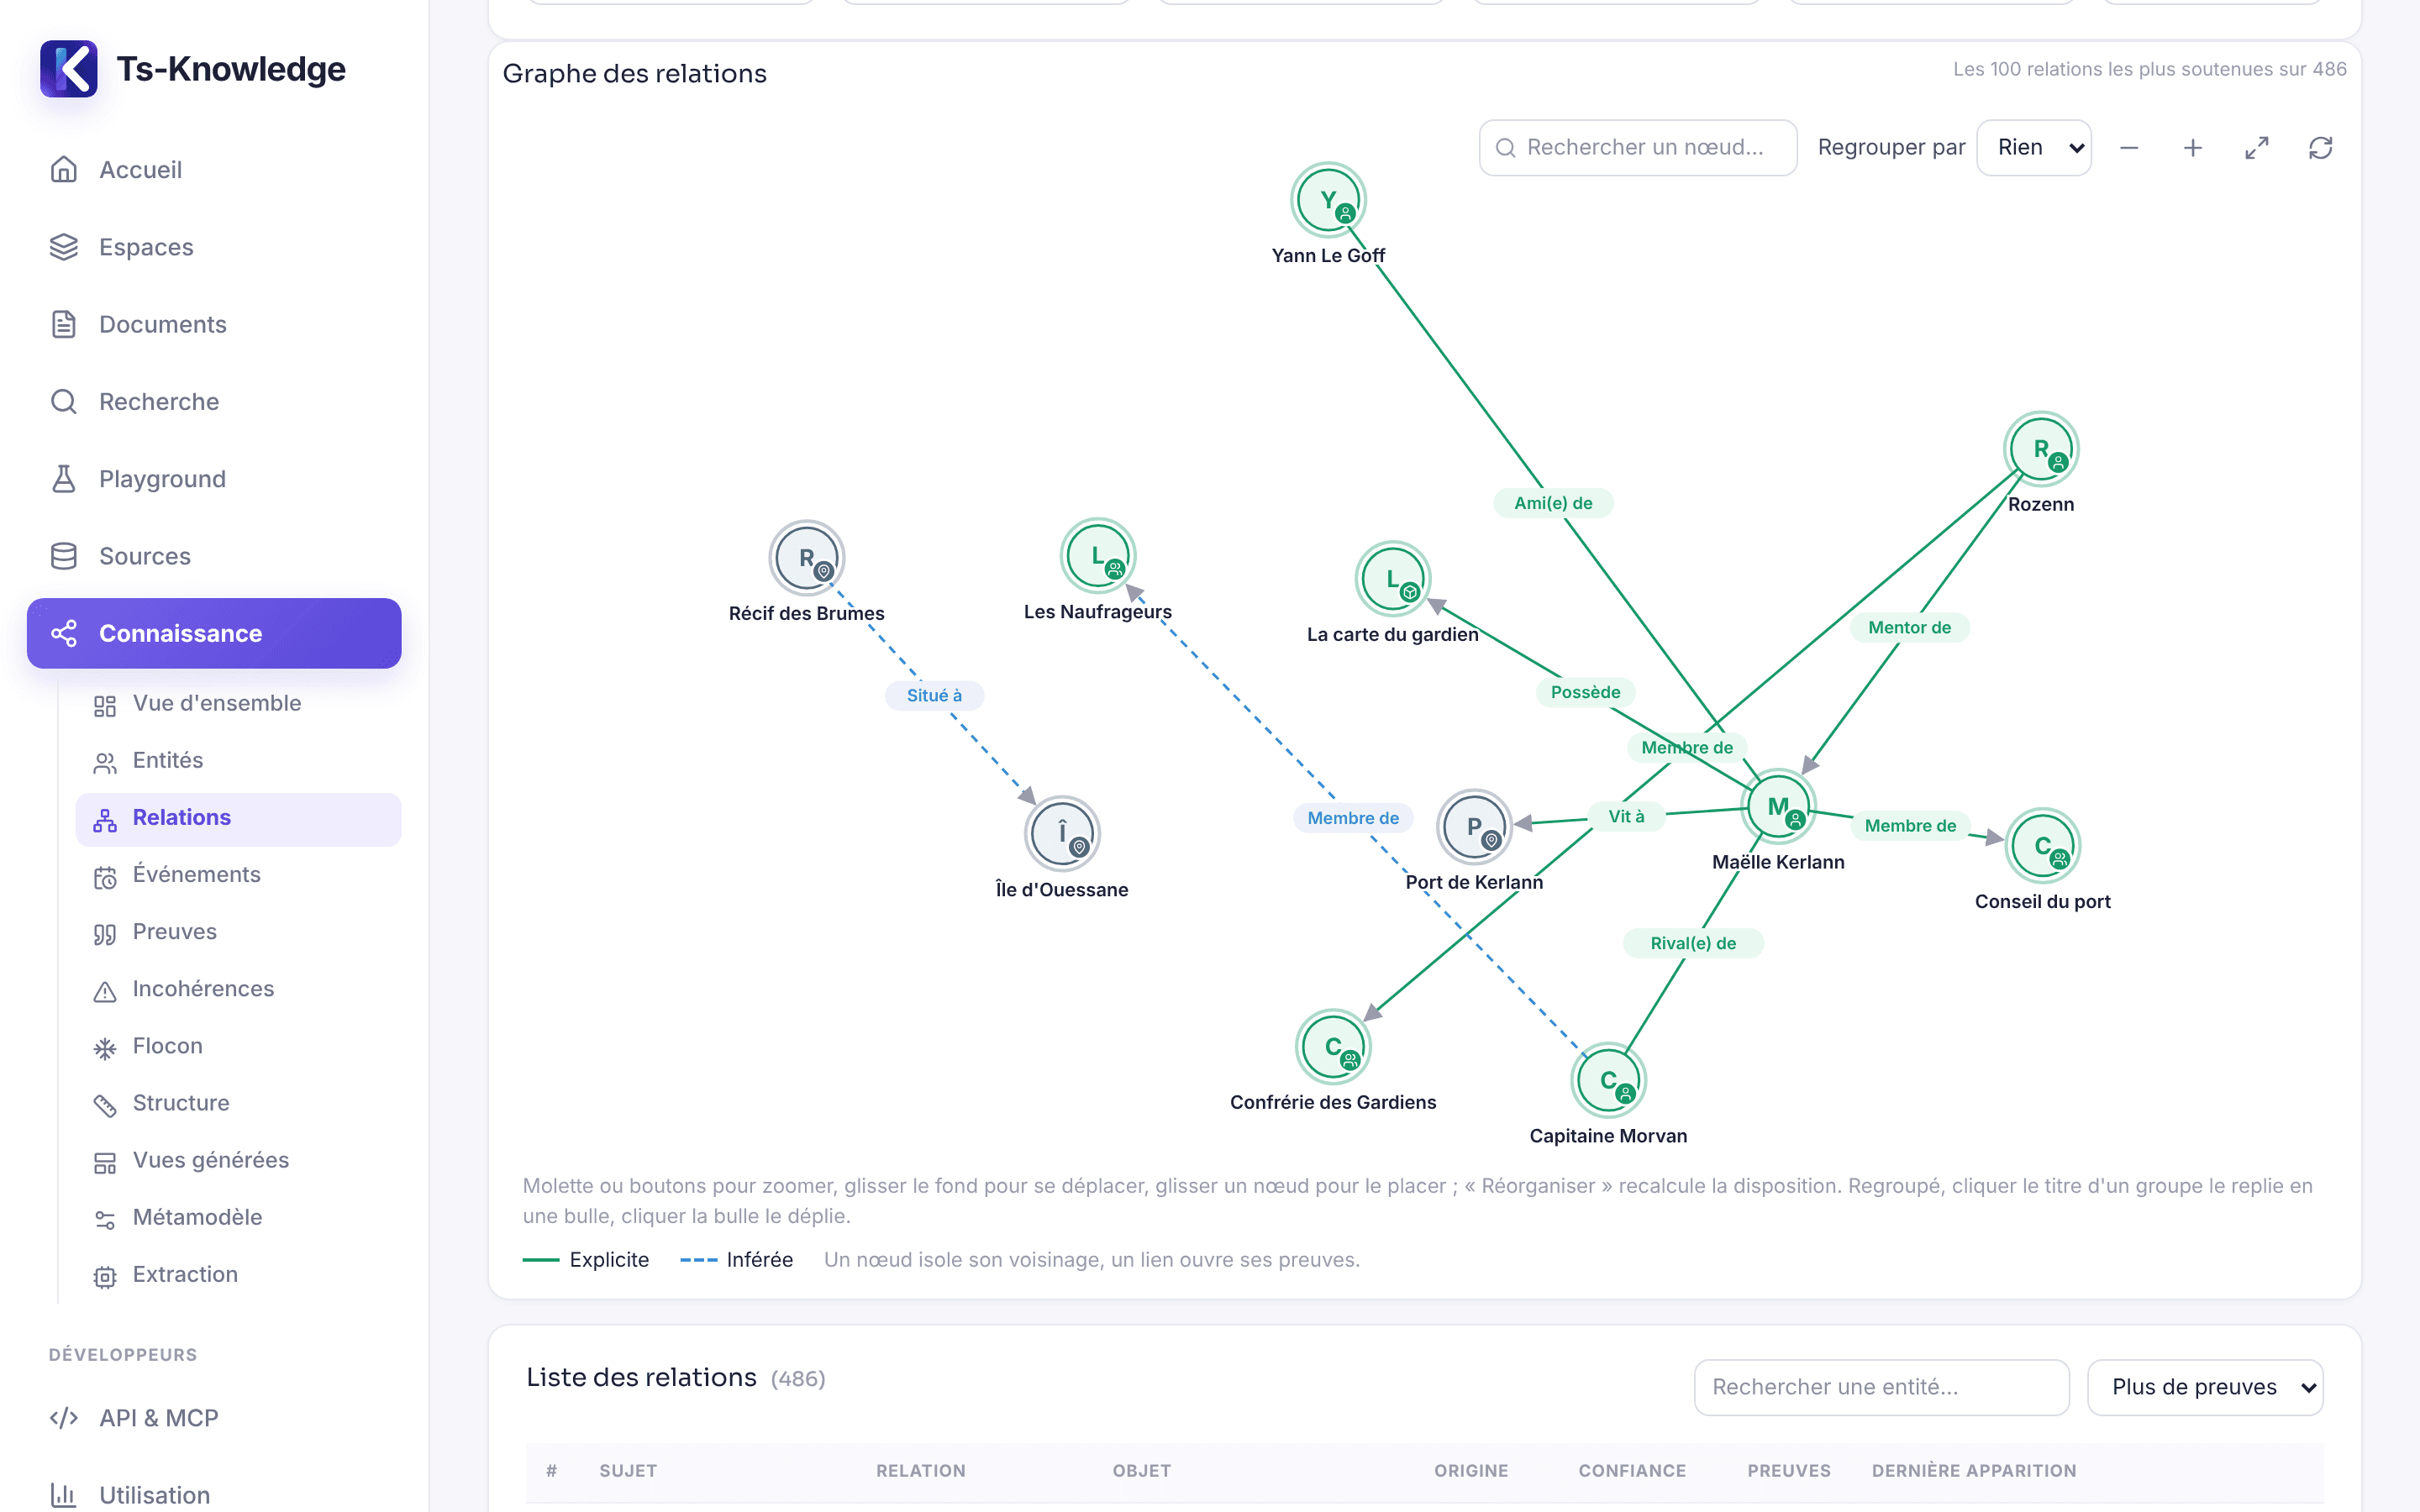
Qui est l'ami, le mentor ou le rival de qui, en graphe navigable. Un lien s'ouvre sur les passages qui l'établissent.
Les événements datés ou ordonnés selon le récit, avec leurs participants et le document où ils se produisent.
Deux valeurs qui ne peuvent pas être vraies ensemble — même contexte, même période — sont signalées, classées par gravité, jamais tranchées à votre place.
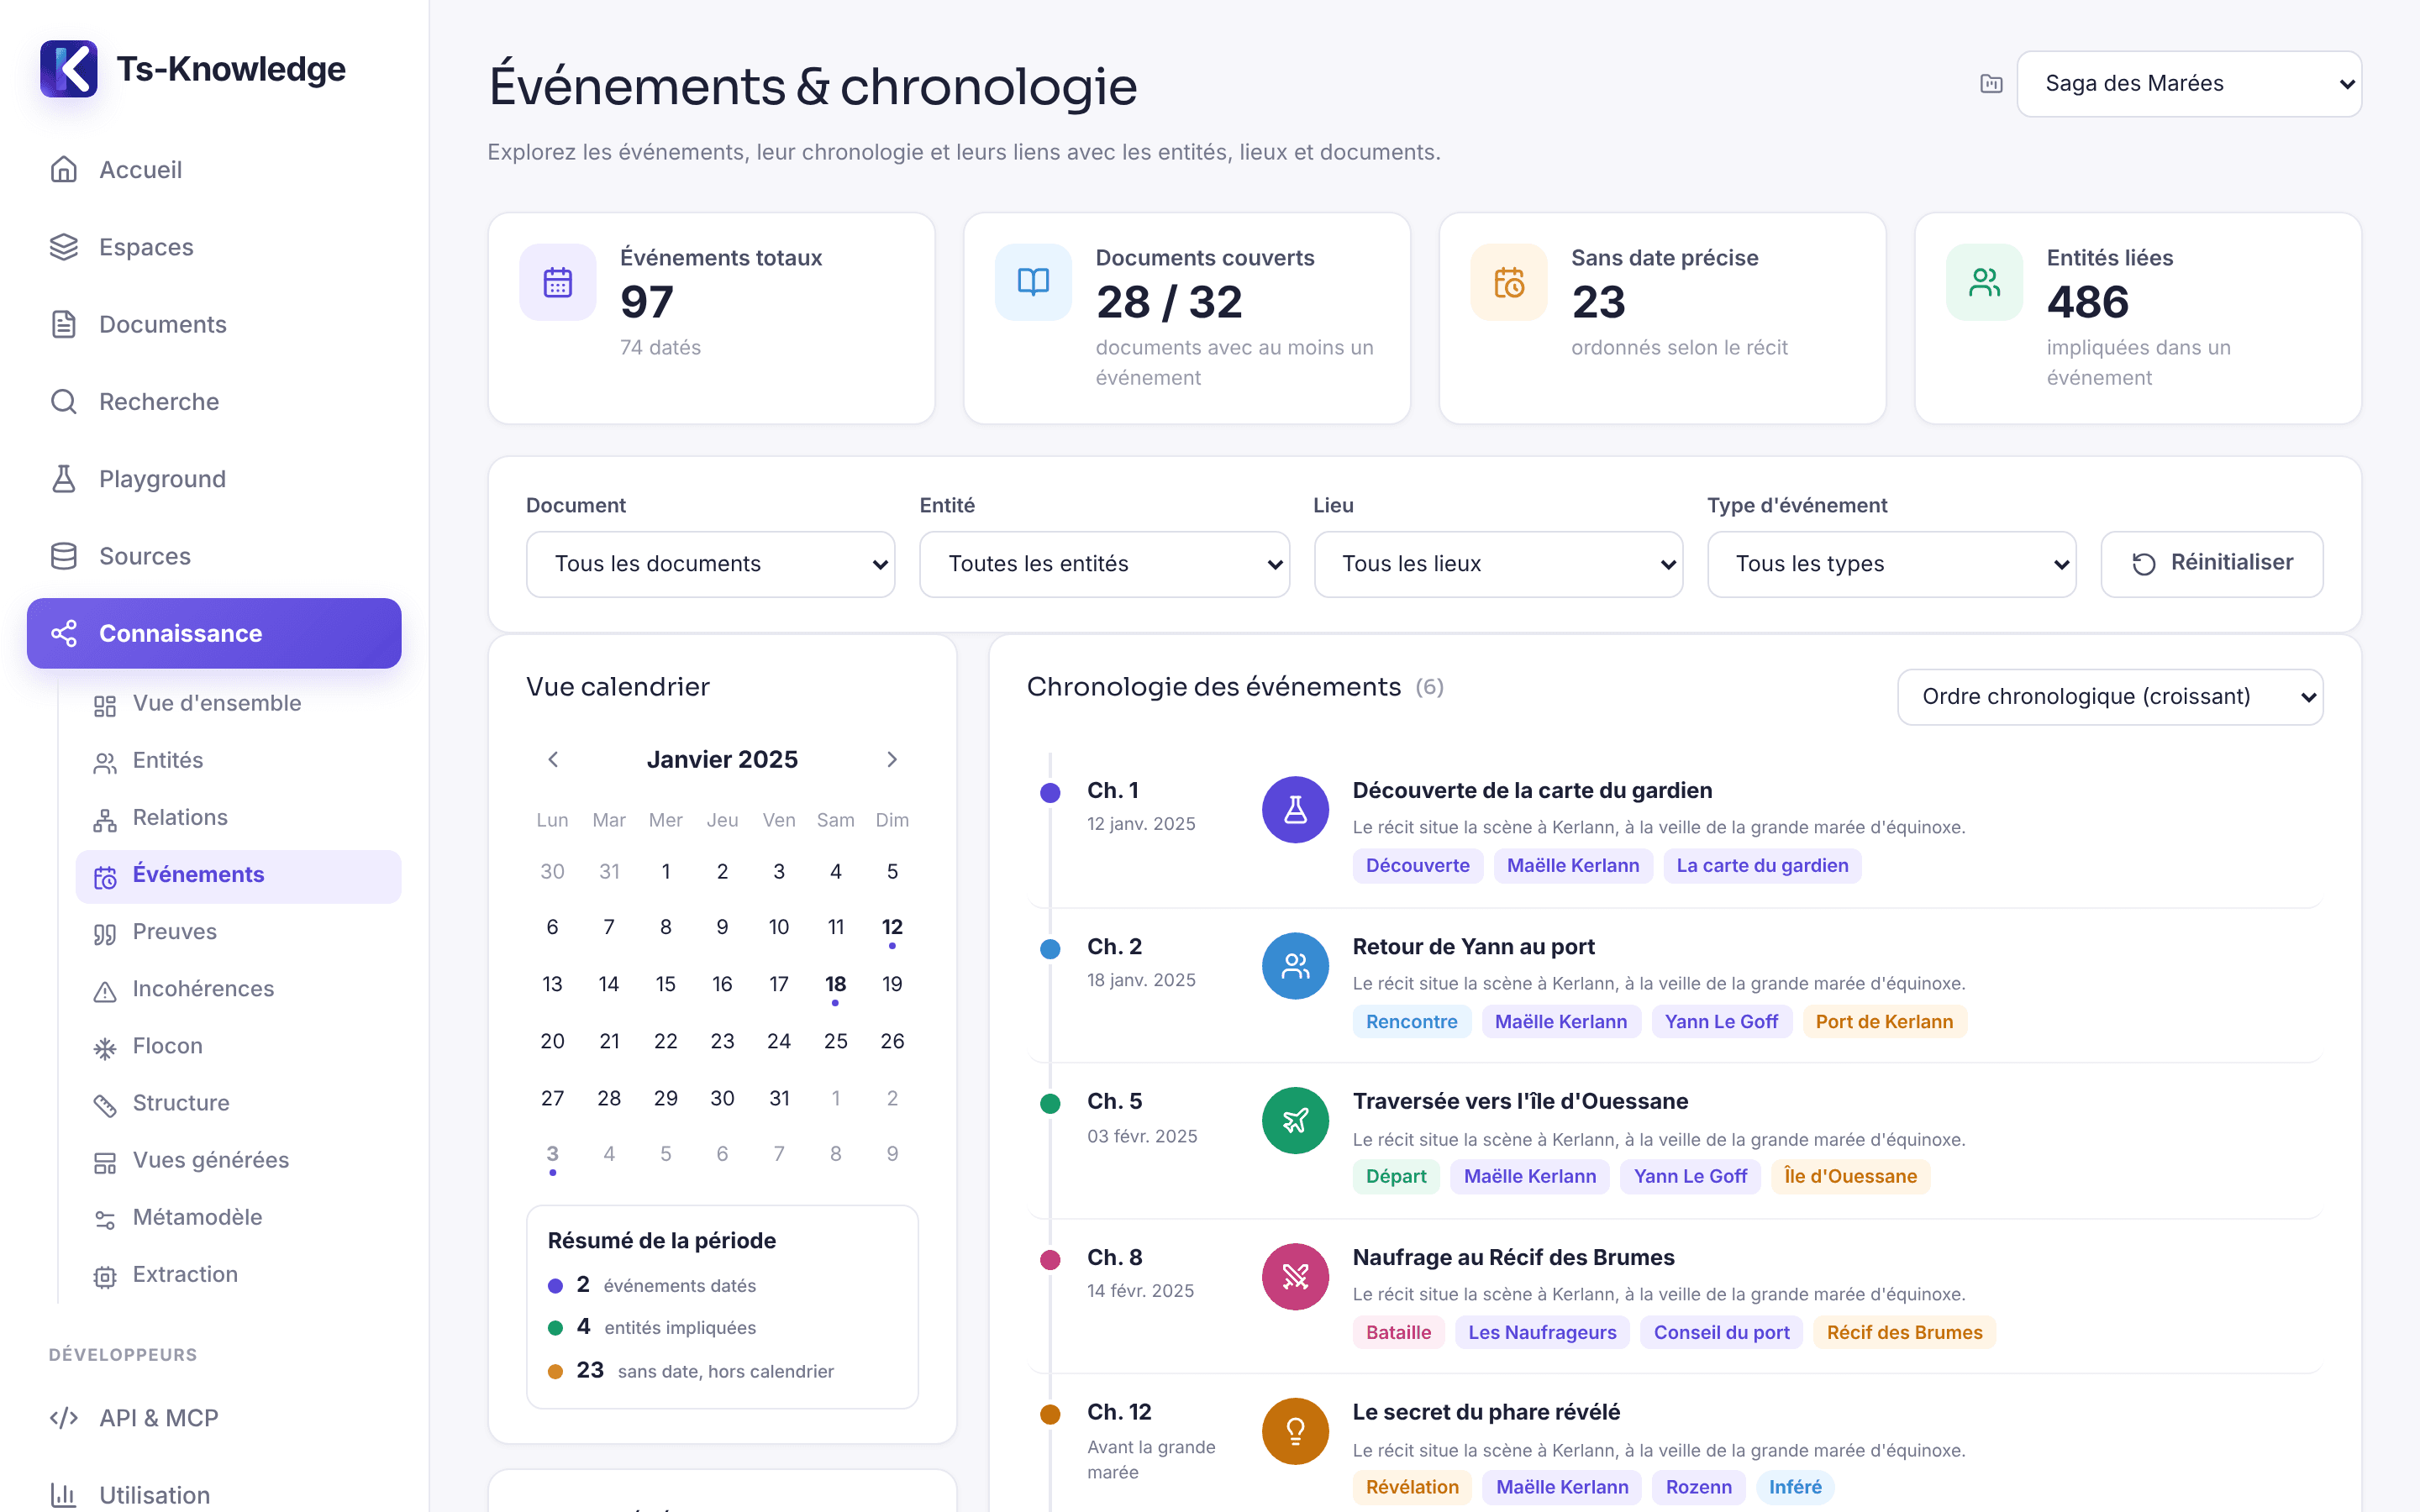
Nouveau · le Flocon
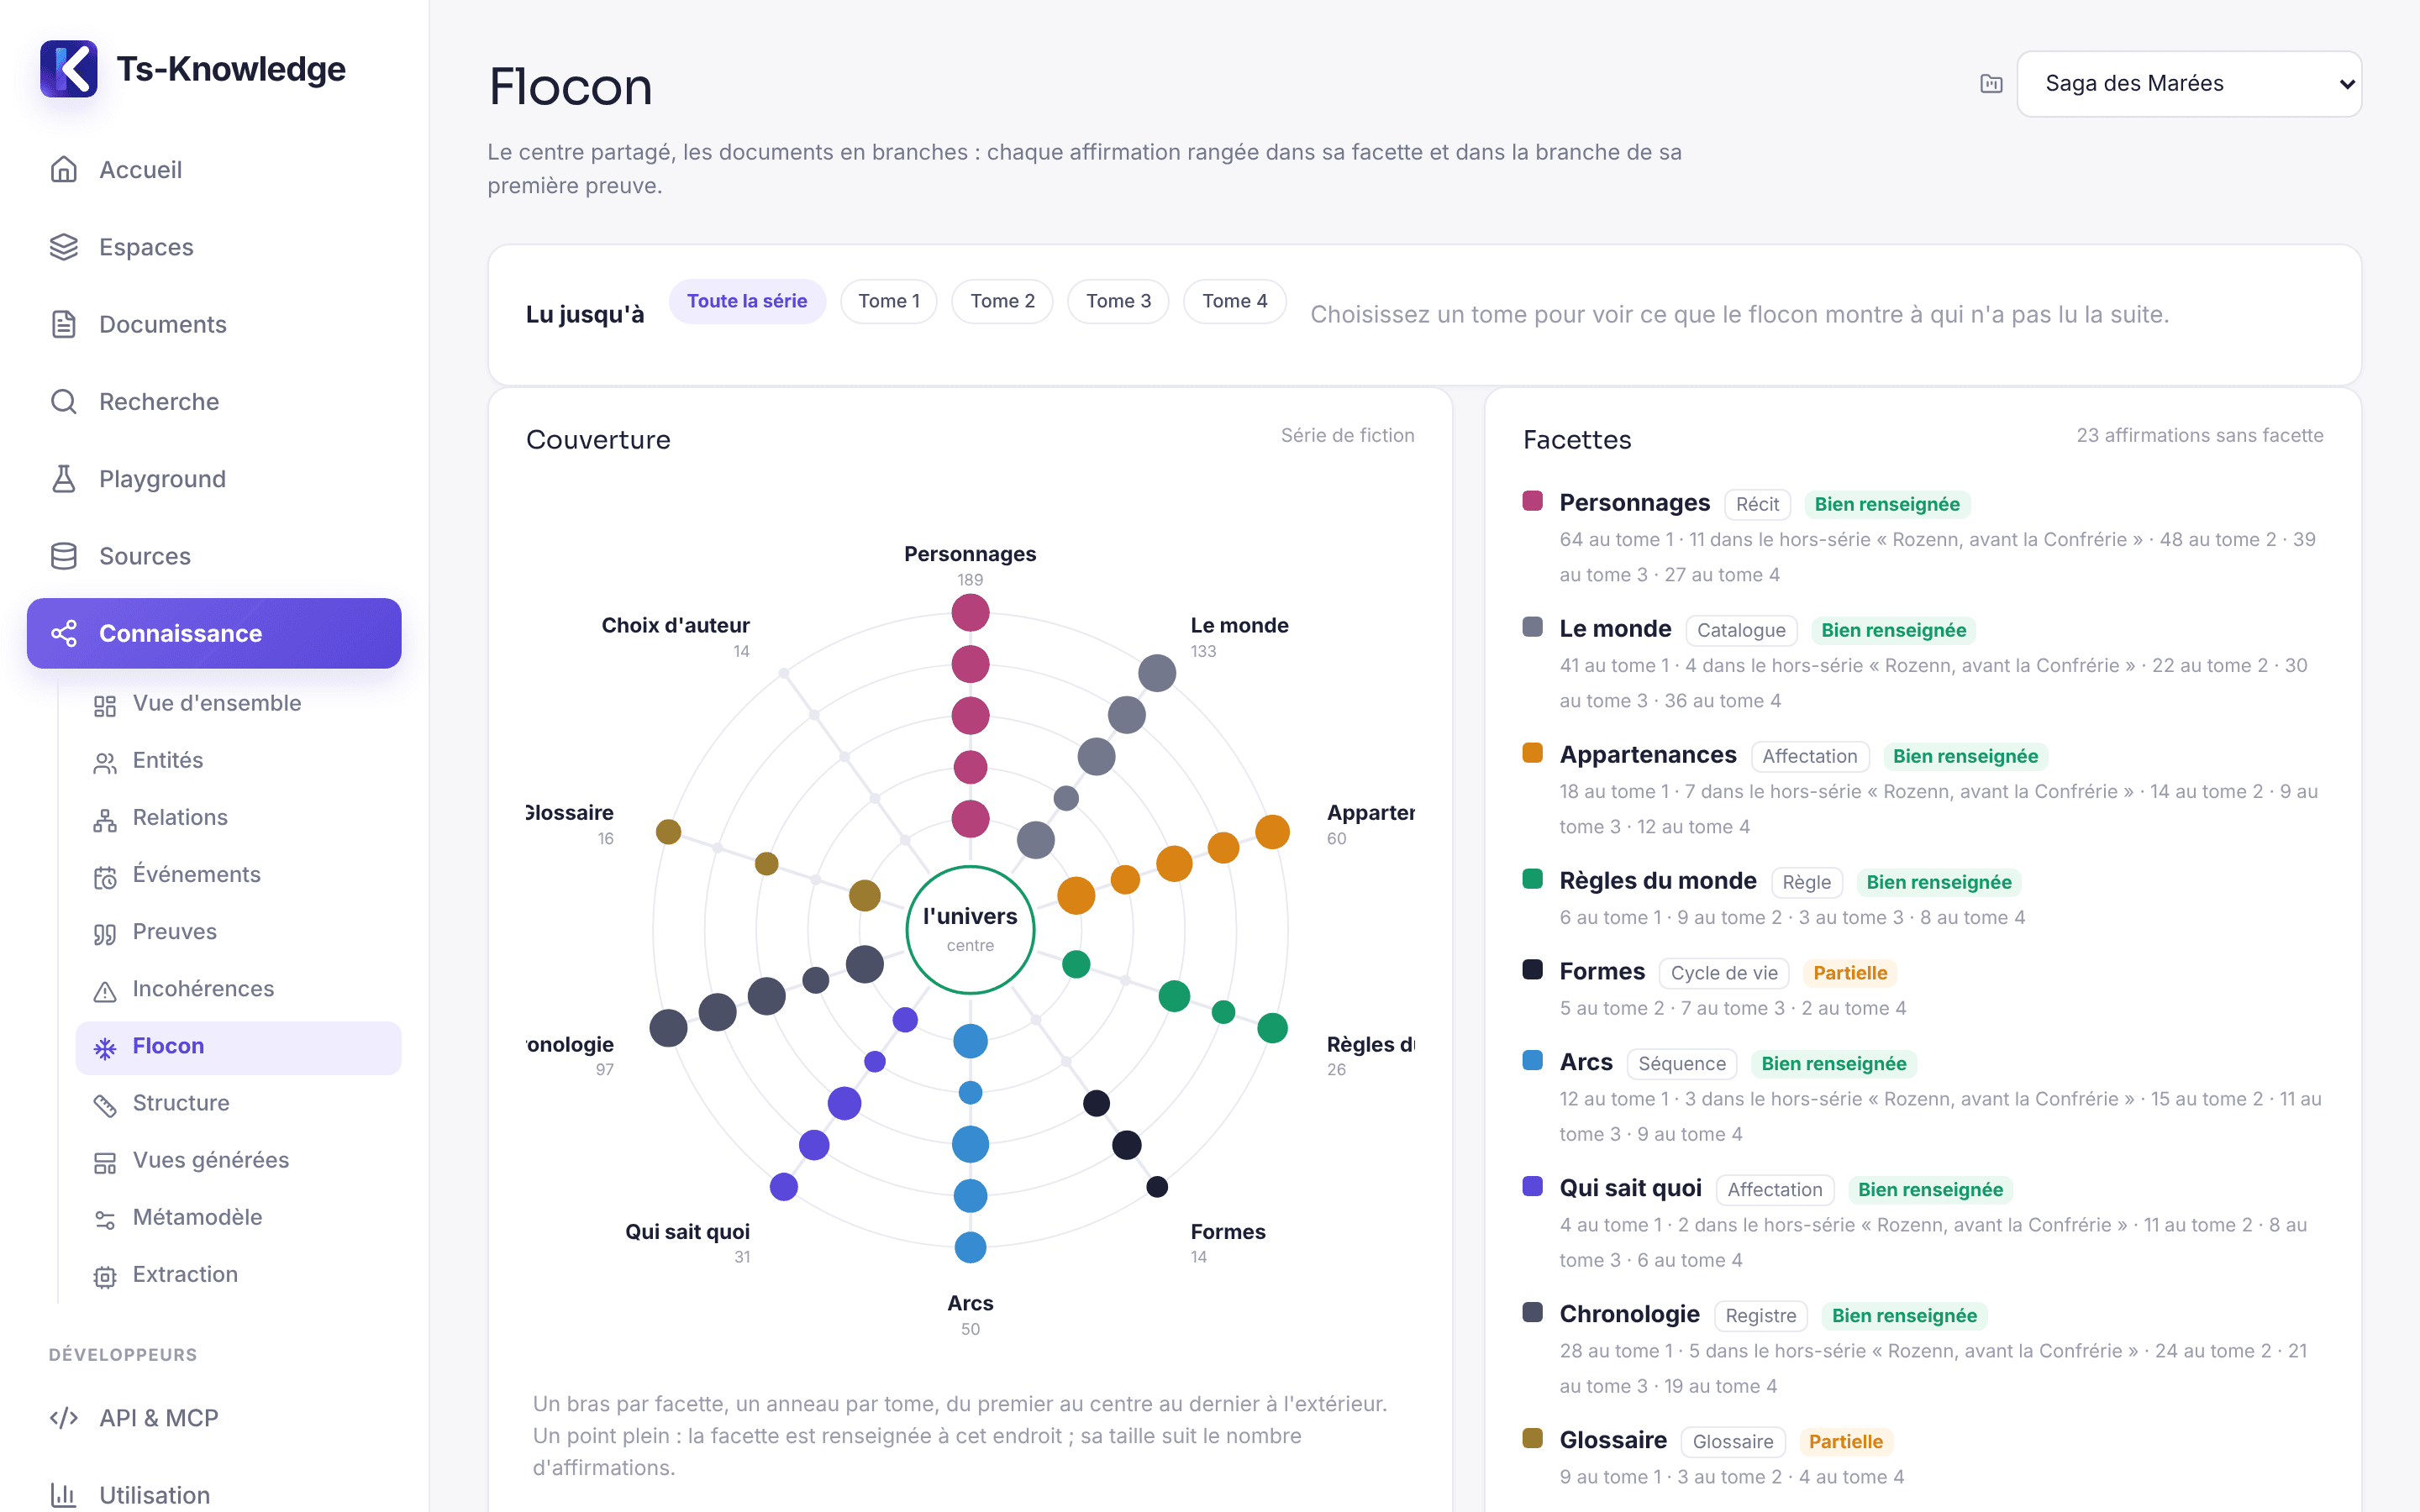
Deux cents personnages, quatre tomes, un hors-série, des règles du monde et des secrets que tout le monde ne connaît pas encore : à partir d'une certaine taille, aucune liste ne suffit plus. Le Flocon range toute la connaissance d'un projet en facettes, tome par tome, et vous montre en un regard ce qui est solide — et ce qui manque.
Personnages, monde, appartenances, règles du monde, formes, arcs, « qui sait quoi », chronologie, glossaire, choix d'auteur : chaque facette devient un bras du flocon, chaque tome un anneau. Plus le point est gros, plus le tome en dit.
Le graphe du flocon colore chaque lien selon sa facette : qui aime qui, qui appartient à quel clan, qui connaît quel secret. Zoomez, déplacez, regroupez par facette, par type ou par tome.
get_knowledge_flake lui donne la carte du projet — où chercher, et ce qui manque — avant même sa première recherche.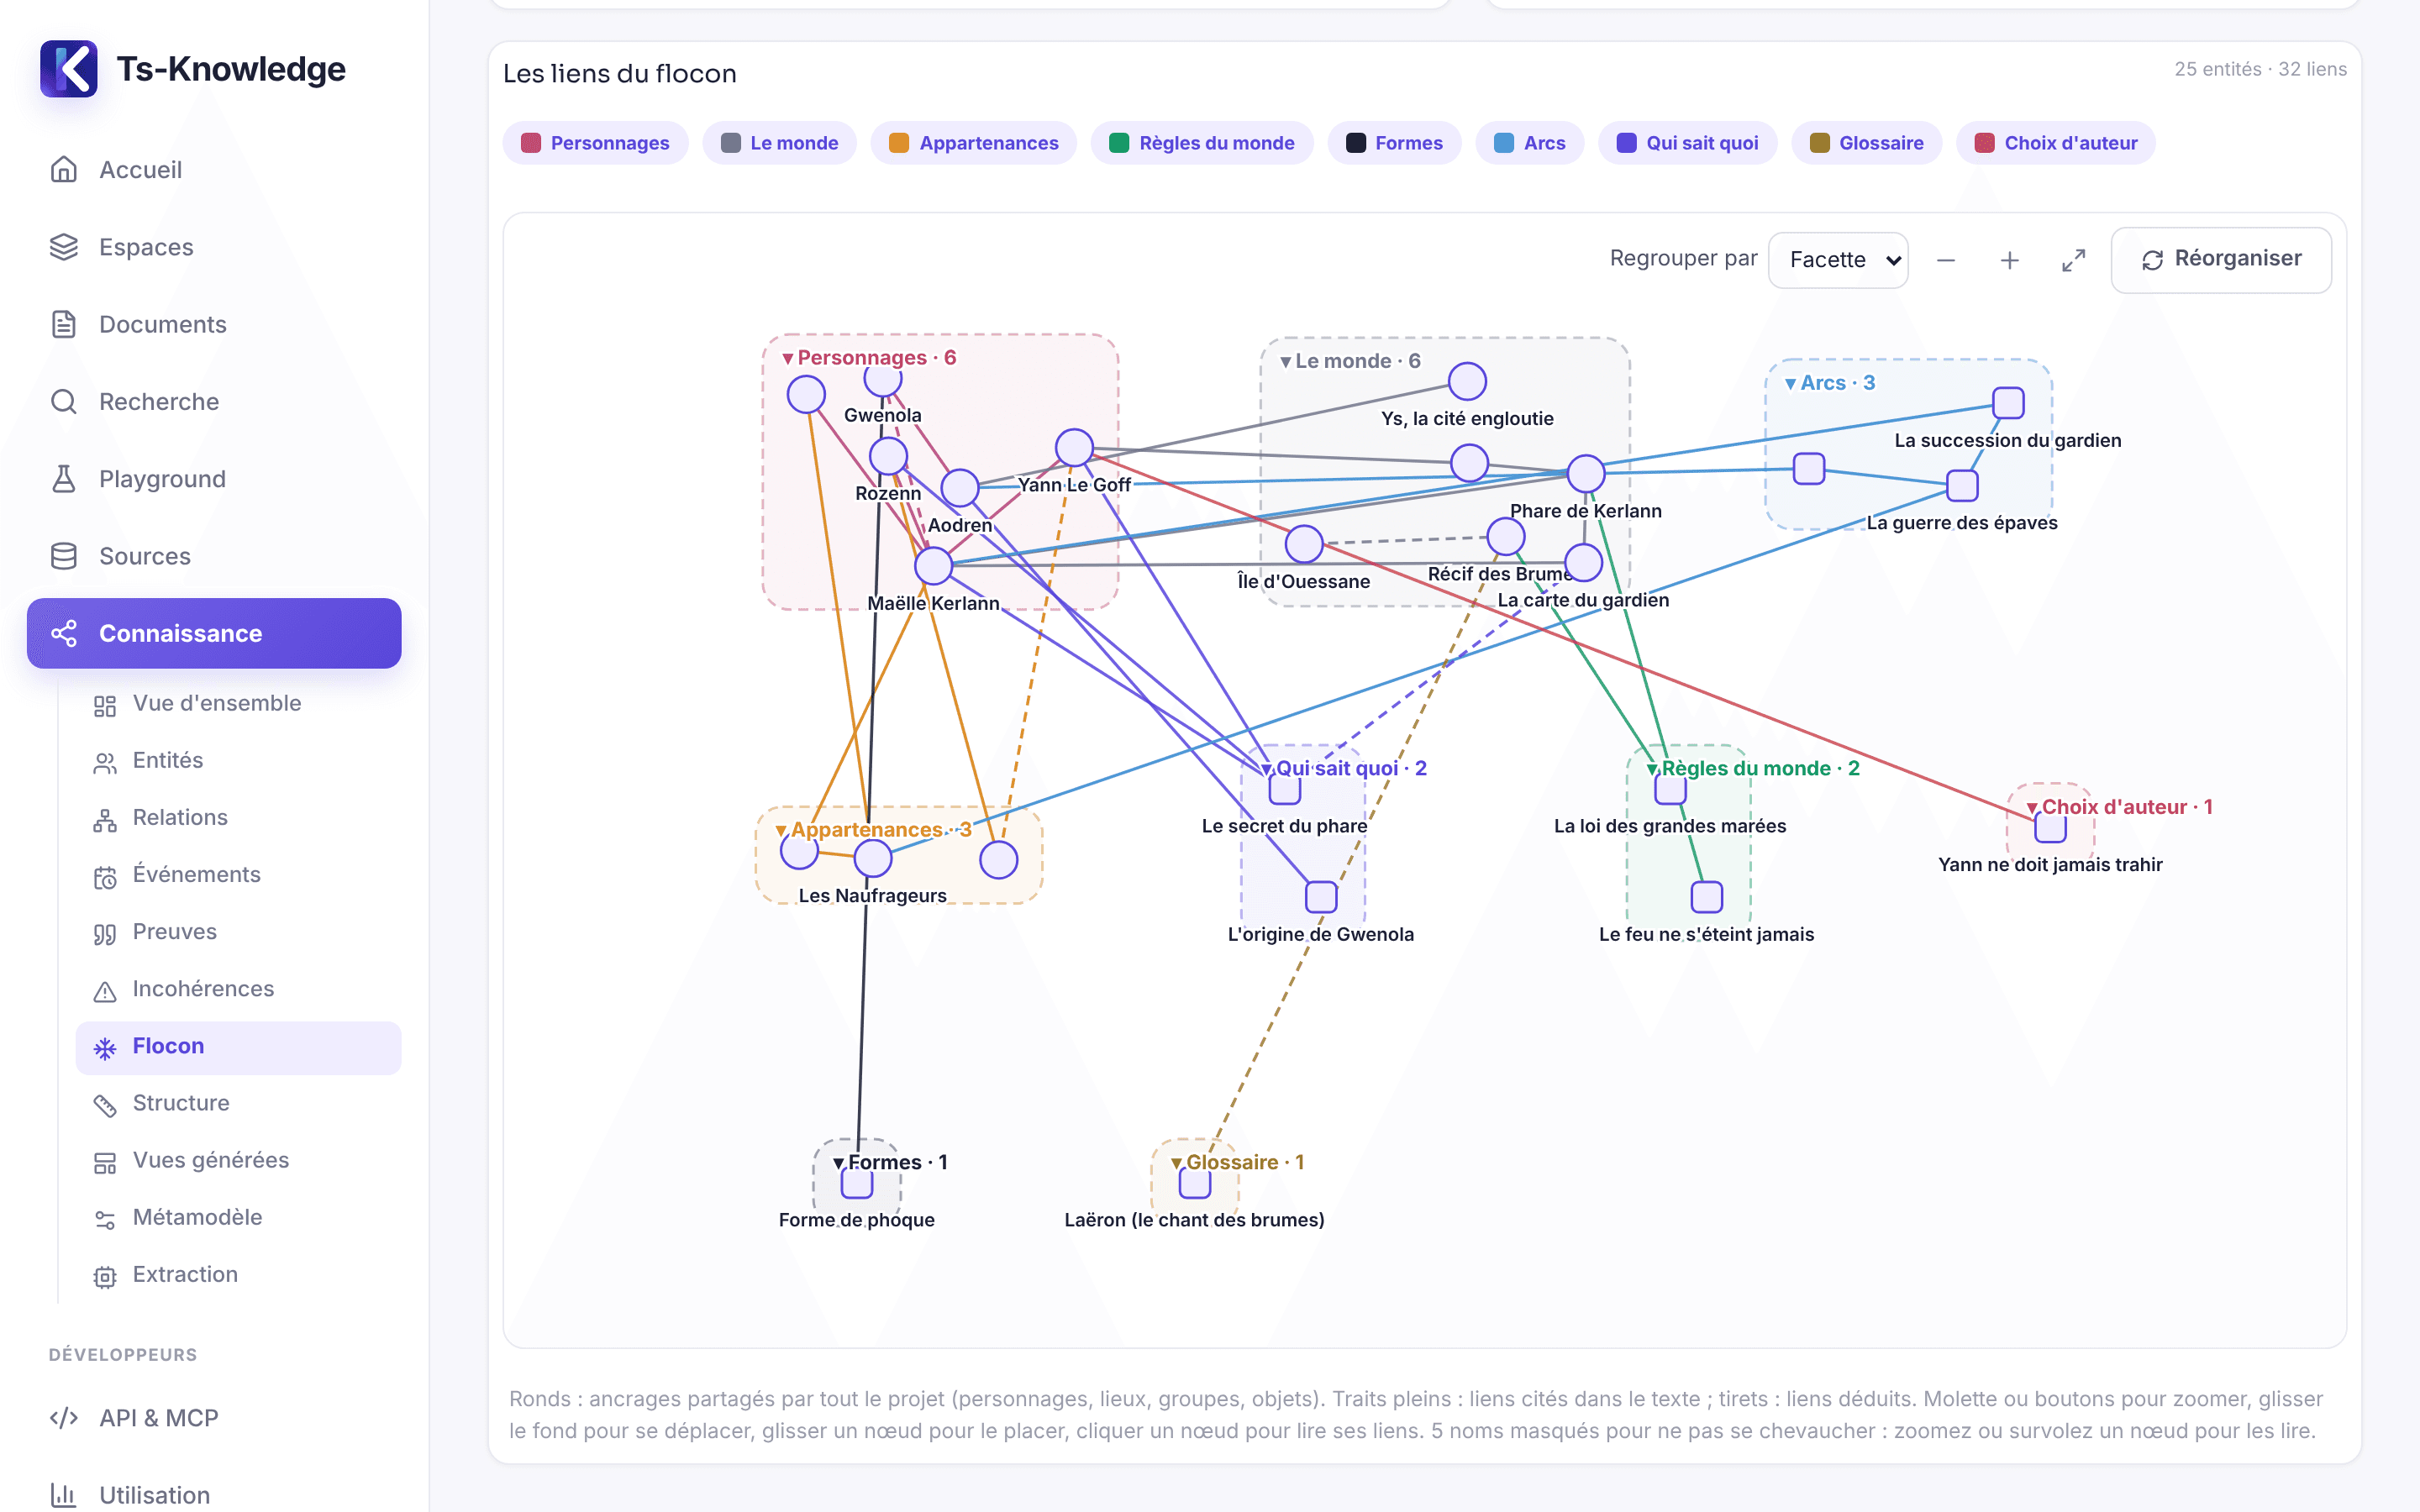
Tomes, hors-séries, notes et brouillons d'un même univers : la bible de votre série, tenue à jour toute seule à chaque chapitre importé.
Objets métier, processus, règles, décisions, systèmes : le même flocon dessine la carte d'une boutique en ligne ou d'un service, étape par étape.
La limite de lecture borne tout : extraits, entités, faits, liens et noms. Dans le doute, le flocon se tait.
Une connaissance extraite par une IA ne vaut que si l'on peut savoir d'où elle vient. Quatre règles tiennent cette couche, et aucune n'est réglable.
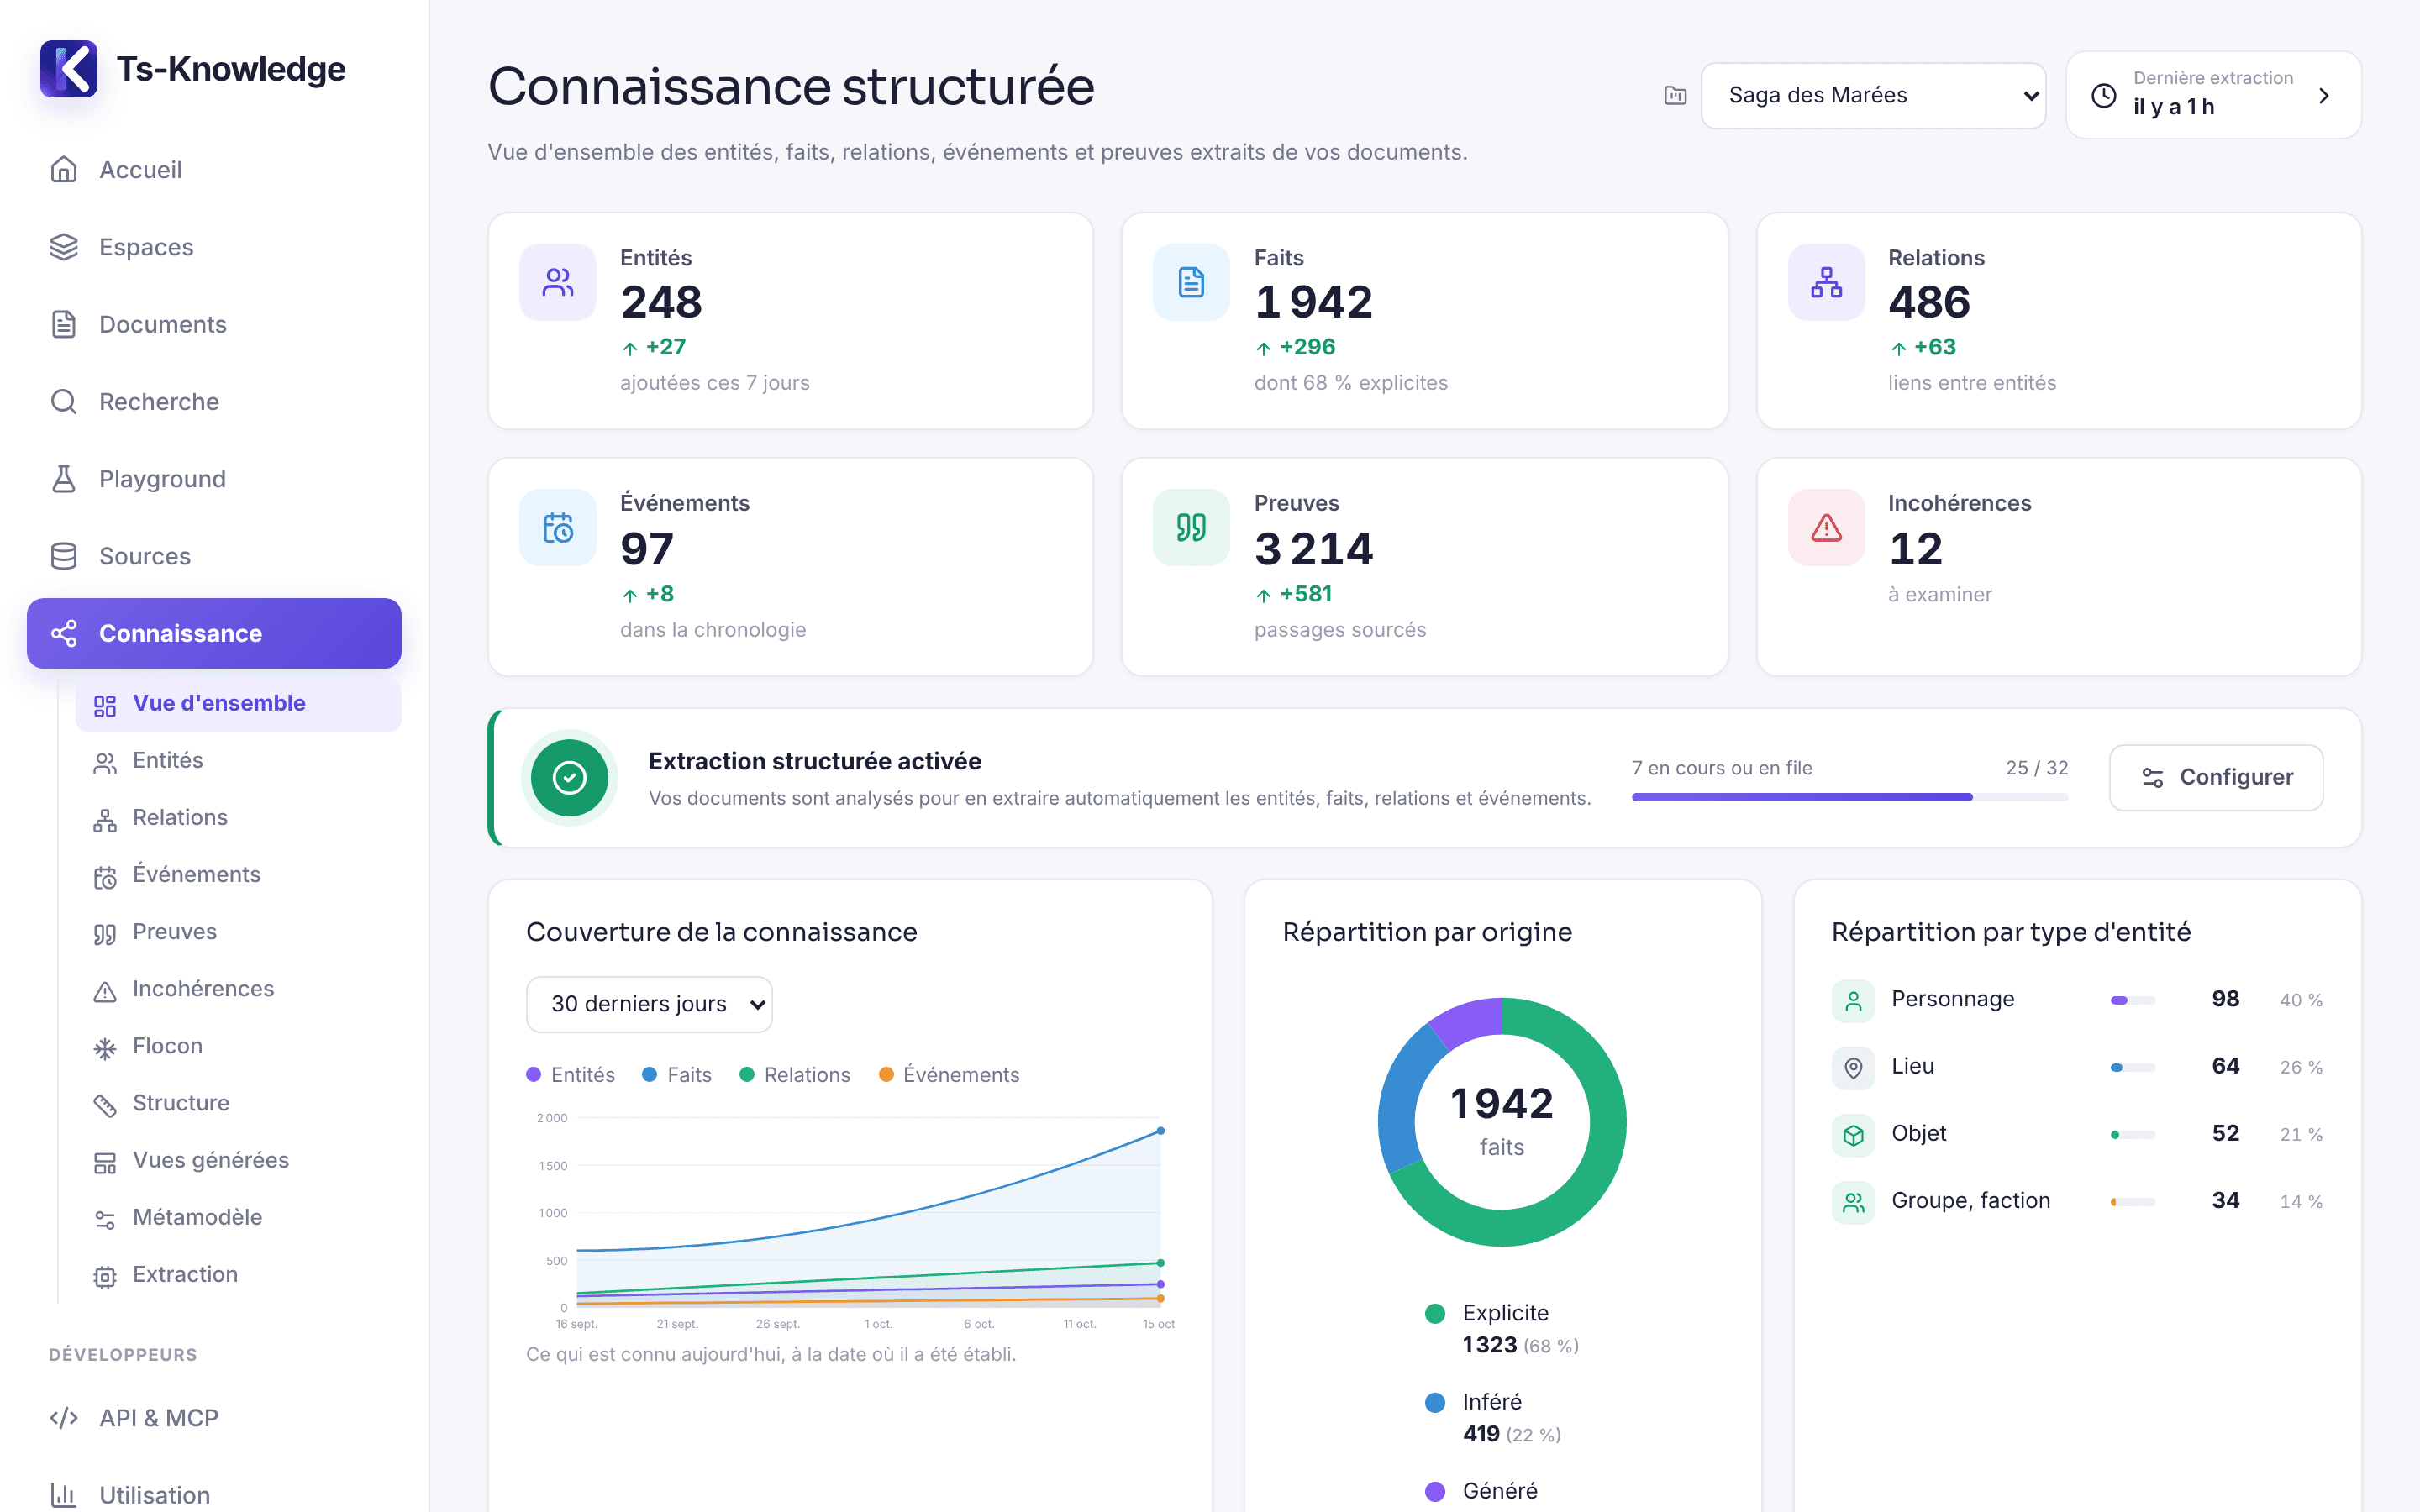
Activez l'extraction sur un espace : chaque document importé est lu en arrière-plan par le modèle que vous avez branché, avec votre clé et à votre compte. La recherche n'attend jamais l'extraction.
Votre agent peut faire la lecture lui-même : le serveur lui fournit les consignes, le vocabulaire de l'espace et le texte, puis revérifie ce qu'il propose — avec exactement les mêmes règles.
Désactivée par défaut, activable espace par espace. Le vocabulaire part d'un modèle — générique, livre, logiciel, juridique, e-commerce — et s'adapte à votre métier.
3 · Connecter
Le serveur MCP est l'interface principale de Ts-Knowledge. Tout ce que l'écran propose, votre agent le trouve en outils : chercher, relire, explorer la connaissance structurée — et même l'enrichir. Le modèle qui rédige reste le vôtre.
Qui connaît le secret du phare, et depuis quand ?
get_knowledge_flakeSaga des Marées · lu jusqu'au tome 210 facettes · « Qui sait quoi » : 13 affirmations, 2 secretssearch_knowledge« secret du phare » · Saga des Marées3 extraits · tome 2, ch. 12, p. 143 · tome 1, ch. 3, p. 21 · …get_knowledge_entityMaëlle Kerlann245 faits · ami : Yann Le Goff · mentor : Rozenn · 1 contradictionMaëlle garde le secret depuis que son père lui a confié les clés du pharetome 1, ch. 3, p. 21. Yann l'a deviné depuis la jetéetome 2, ch. 12, p. 143. Les tomes divergent sur son âge à ce moment-là (16 ou 17 ans).
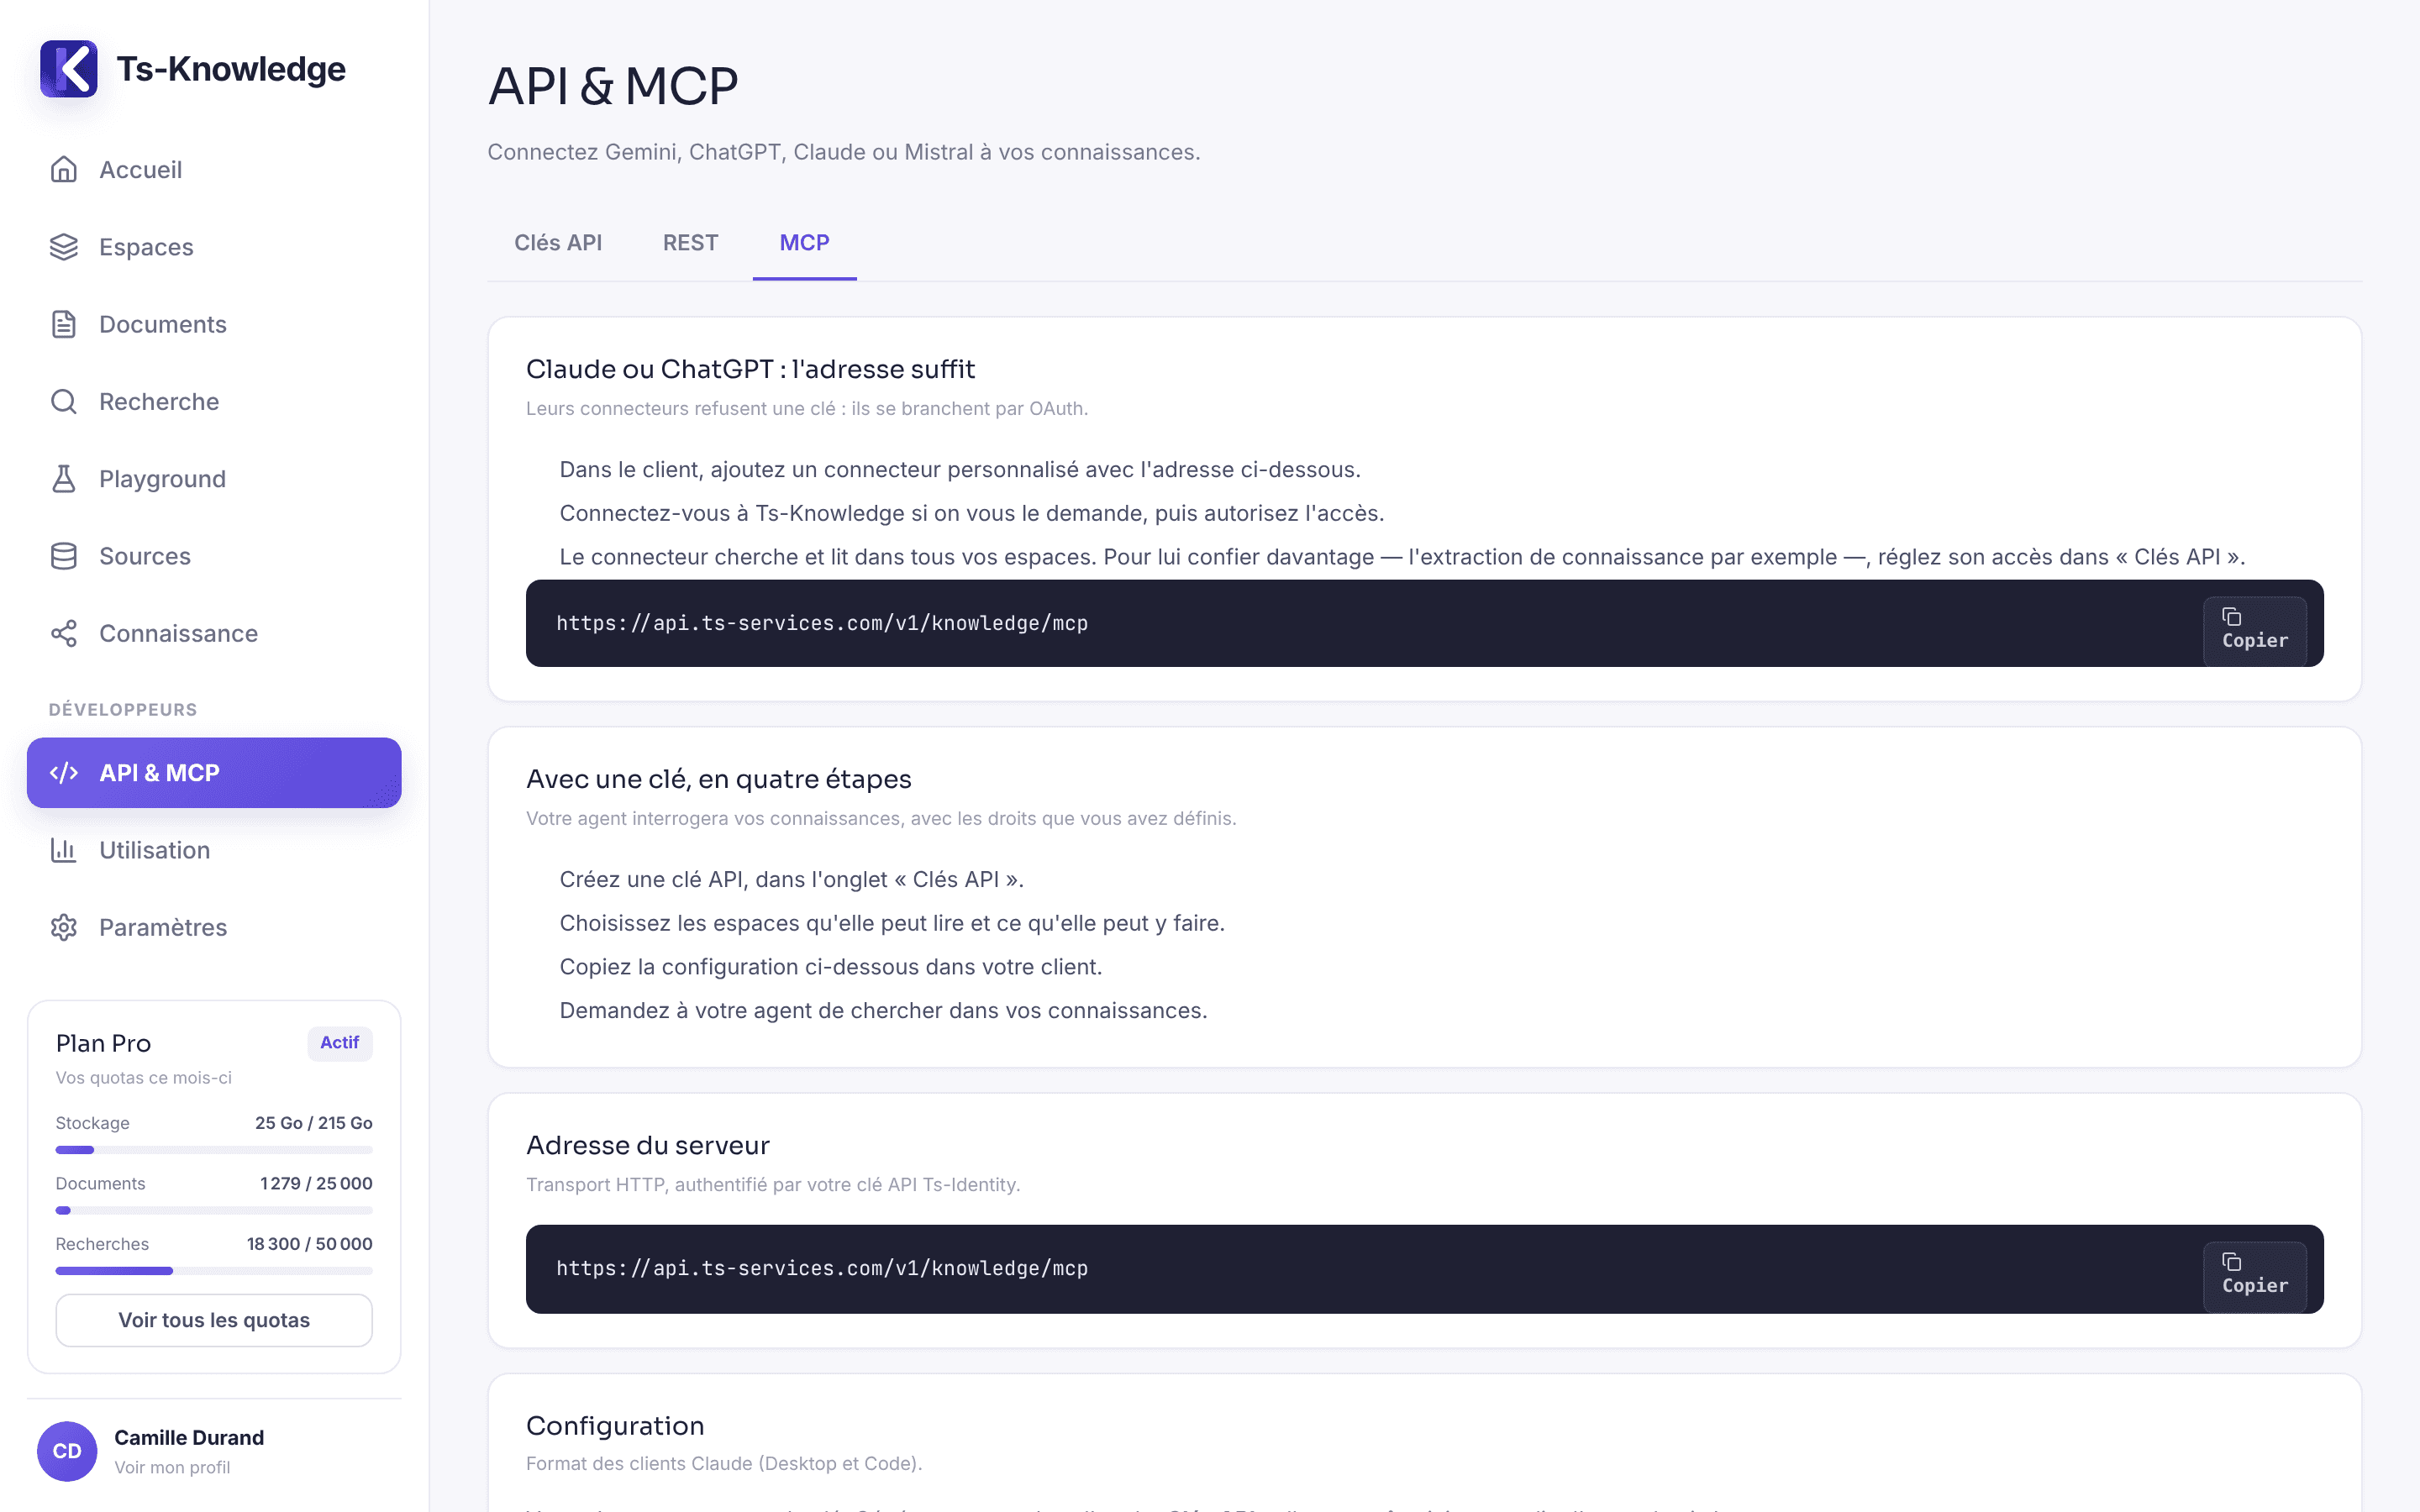
report_used_chunks2 extraits ont servilist_knowledge_spacesles espaces ouverts à la clélist_knowledge_collectionsles collections d'un espacelist_knowledge_labelsles étiquettes, pour cibler un périmètrelist_knowledge_documentsles documents et leur statutsearch_knowledgeles passages pertinents, avec leurs citationsresearch_knowledgeet, si le corpus ne suffit pas, vos sources branchéesget_knowledge_documentun document et ses métadonnéesget_knowledge_chunkun extrait et son contexte immédiatget_document_outlinele plan d'un long documentlist_knowledge_entitiespersonnages, lieux, services, articles…get_knowledge_entityla fiche : faits, relations, événementsget_entity_relationsqui est lié à qui, et commentget_knowledge_flakela carte d'un projet : ses facettes, tome par tome, et ce qui manqueget_entity_evidenceles passages qui le prouventlist_knowledge_conflictsles incohérences du projet, valeurs et preuves en regardlist_knowledge_extractionsoù en est la lecture de chaque documentget_story_rhythmle rythme d'un tome au regard de la grille de structure de son autricestart_knowledge_extractionles consignes et le texte d'un document à liresubmit_knowledge_extractionce que l'agent en a tiré, revérifié par le serveurmerge_knowledge_entitiesréunir deux entités qui n'en font qu'une, sur votre demandepromote_knowledge_entitypartager une entité avec toute la série ou toute l'entreprise, sur votre demandeupdate_knowledge_entitycorriger le nom, les surnoms ou la description d'une entitéset_knowledge_entity_statusarchiver une entité erronée, ou la rétablirset_knowledge_statement_statusécarter un fait, une relation ou un événement faux, sur votre décisionresolve_knowledge_conflictrésoudre une incohérence à partir de votre explicationstart_visual_reference_readingles croquis de l'autrice, pour en lire le style et les traitssubmit_visual_reference_readingle style d'une planche, imposé ensuite à chaque illustrationstart_visual_descriptionles faits d'un personnage, pour en écrire le prompt d'illustrationsubmit_visual_descriptionun prompt d'image par forme, rangé à part sur la ficheset_document_reading_orderl'ordre de lecture d'une série, pour ne rien dévoiler de la suiteset_story_gridune grille de structure narrative, saisie depuis vos notesstart_structure_reviewla grille et les chapitres d'un tome, pour en relire la structuresubmit_structure_reviewune relecture de structure, revérifiée et mesurée par le serveurreport_used_chunksles extraits qui ont vraiment serviGénérez une clé depuis l'écran « API & MCP », choisissez ses espaces et ses permissions, puis collez la configuration dans votre client. Le même index sert aussi l'API REST, pour vos intégrations.
{
  "mcpServers": {
    "ts-knowledge": {
      "type": "http",
      "url": "https://api.ts-services.com/v1/knowledge/mcp",
      "headers": {
        "Authorization": "Bearer VOTRE_CLE_API"
      }
    }
  }
}
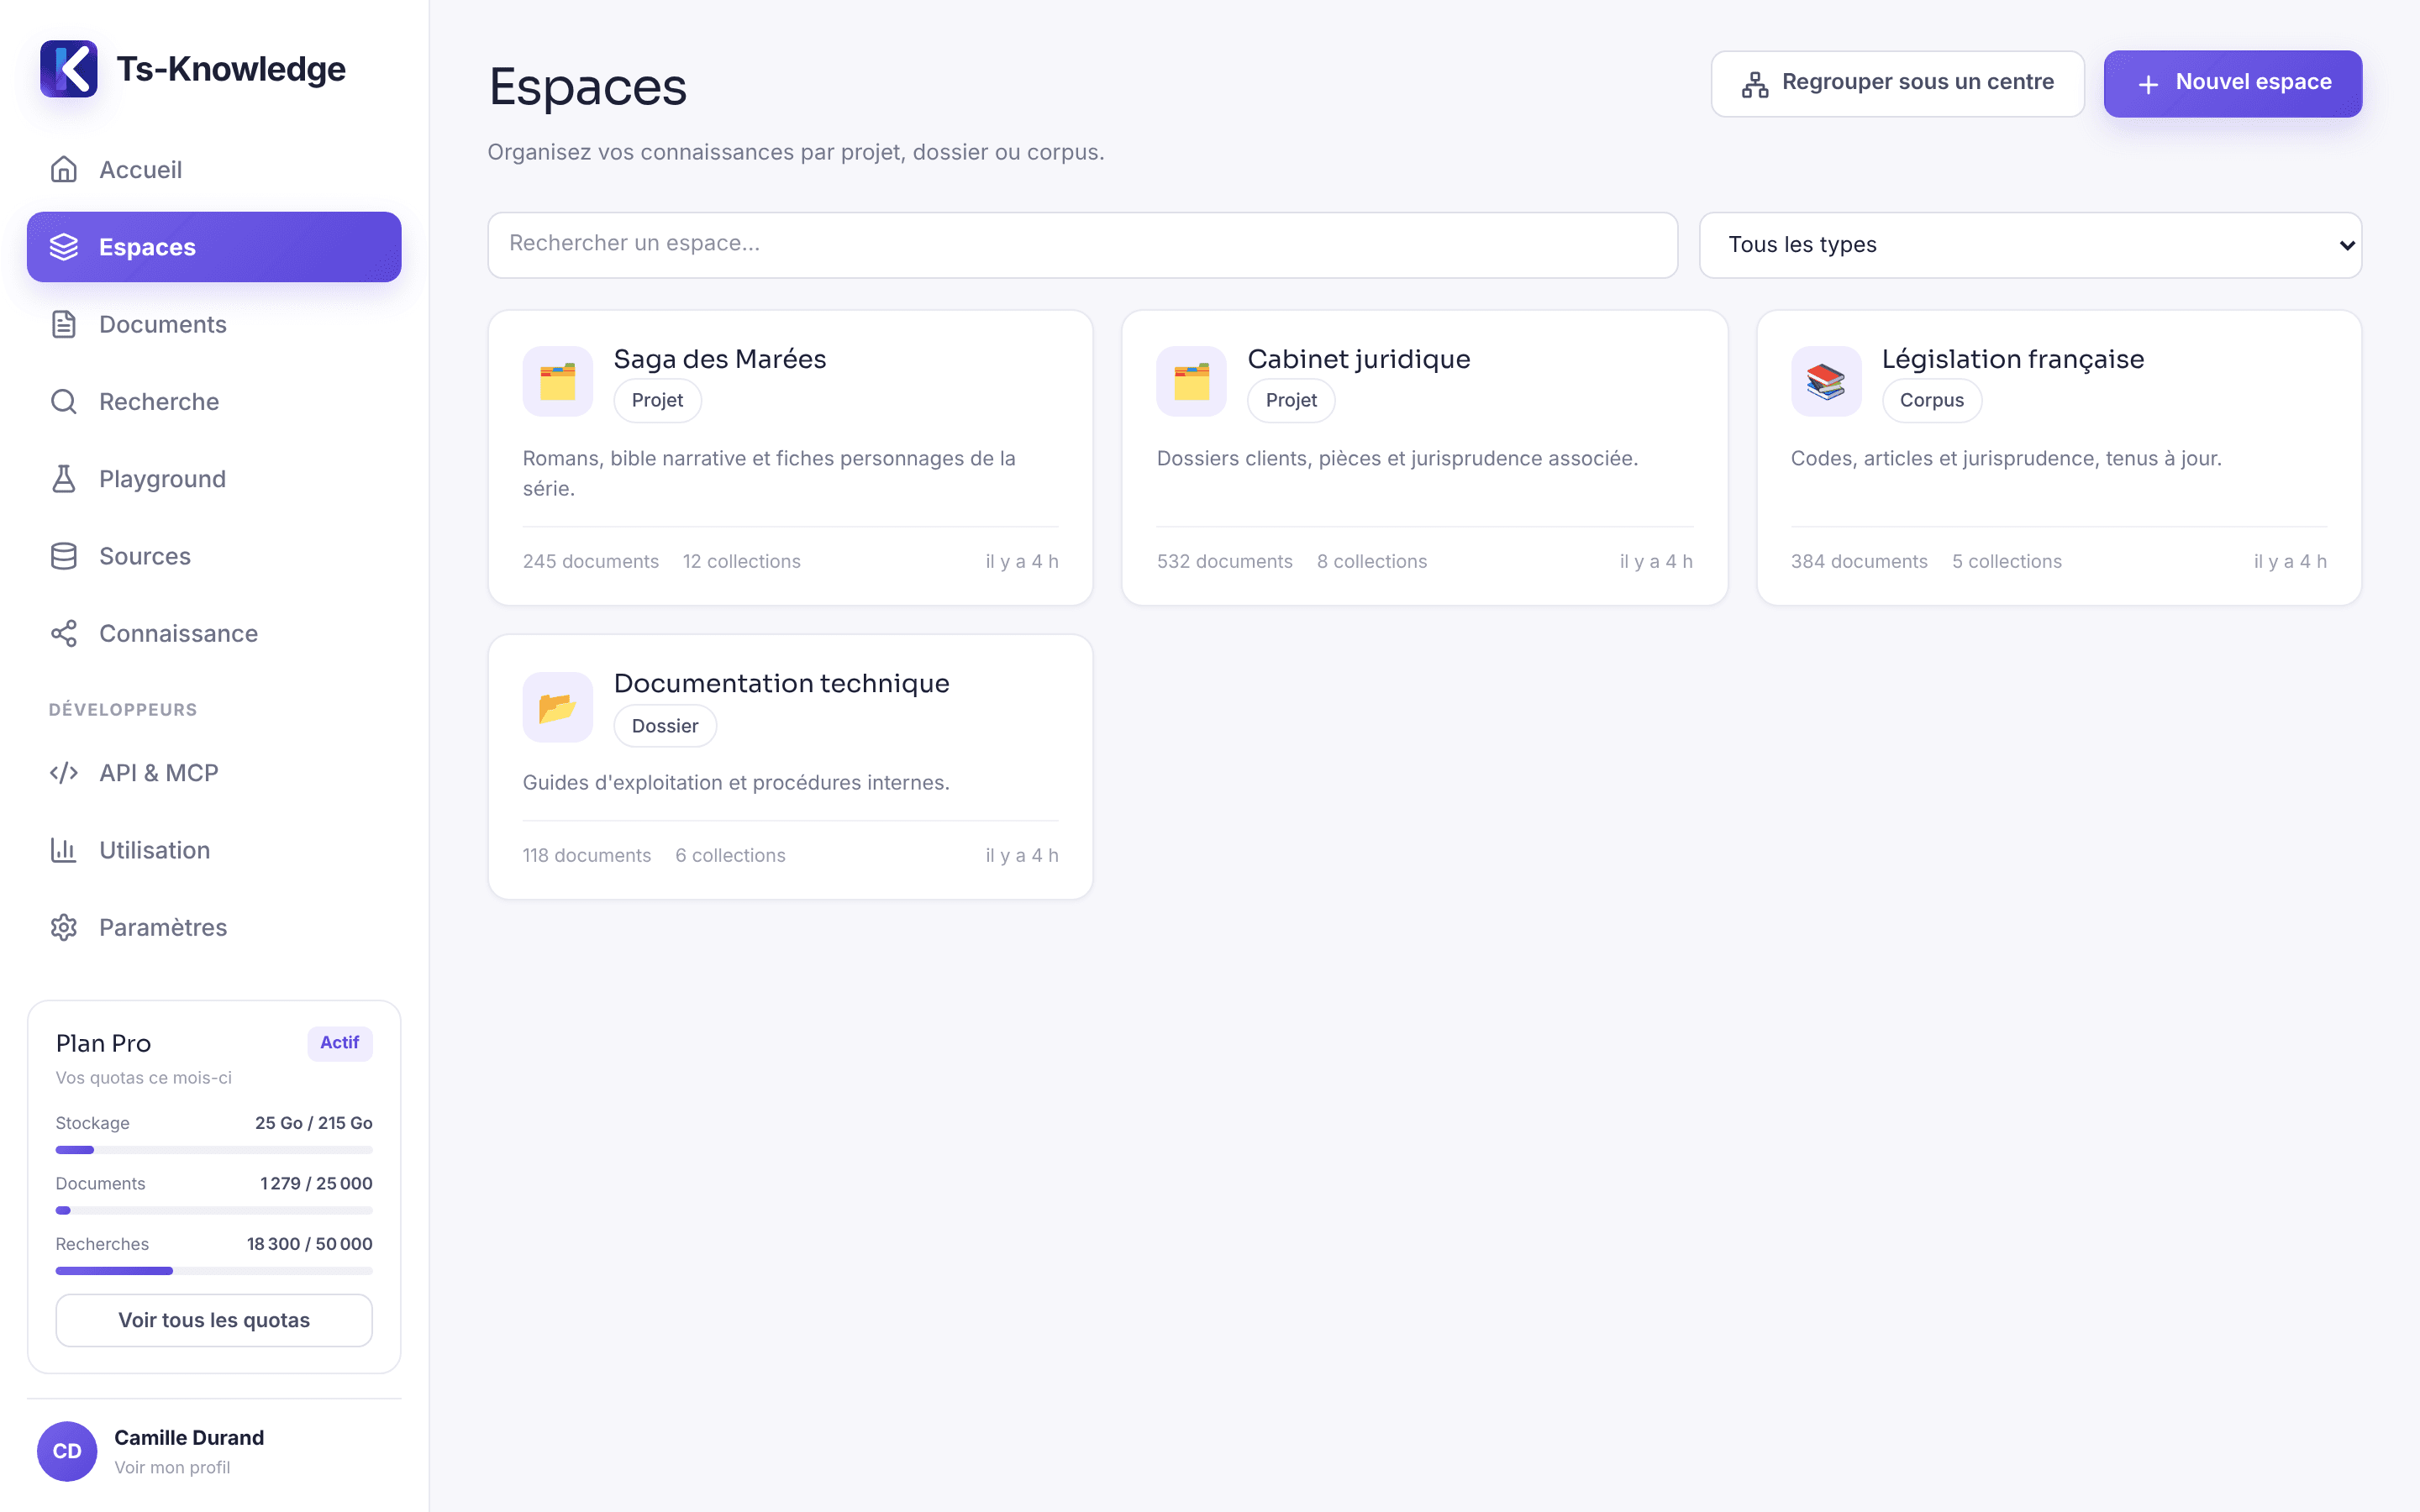
Un projet, un dossier client, un corpus documentaire : la frontière qui déterminera qui voit quoi.
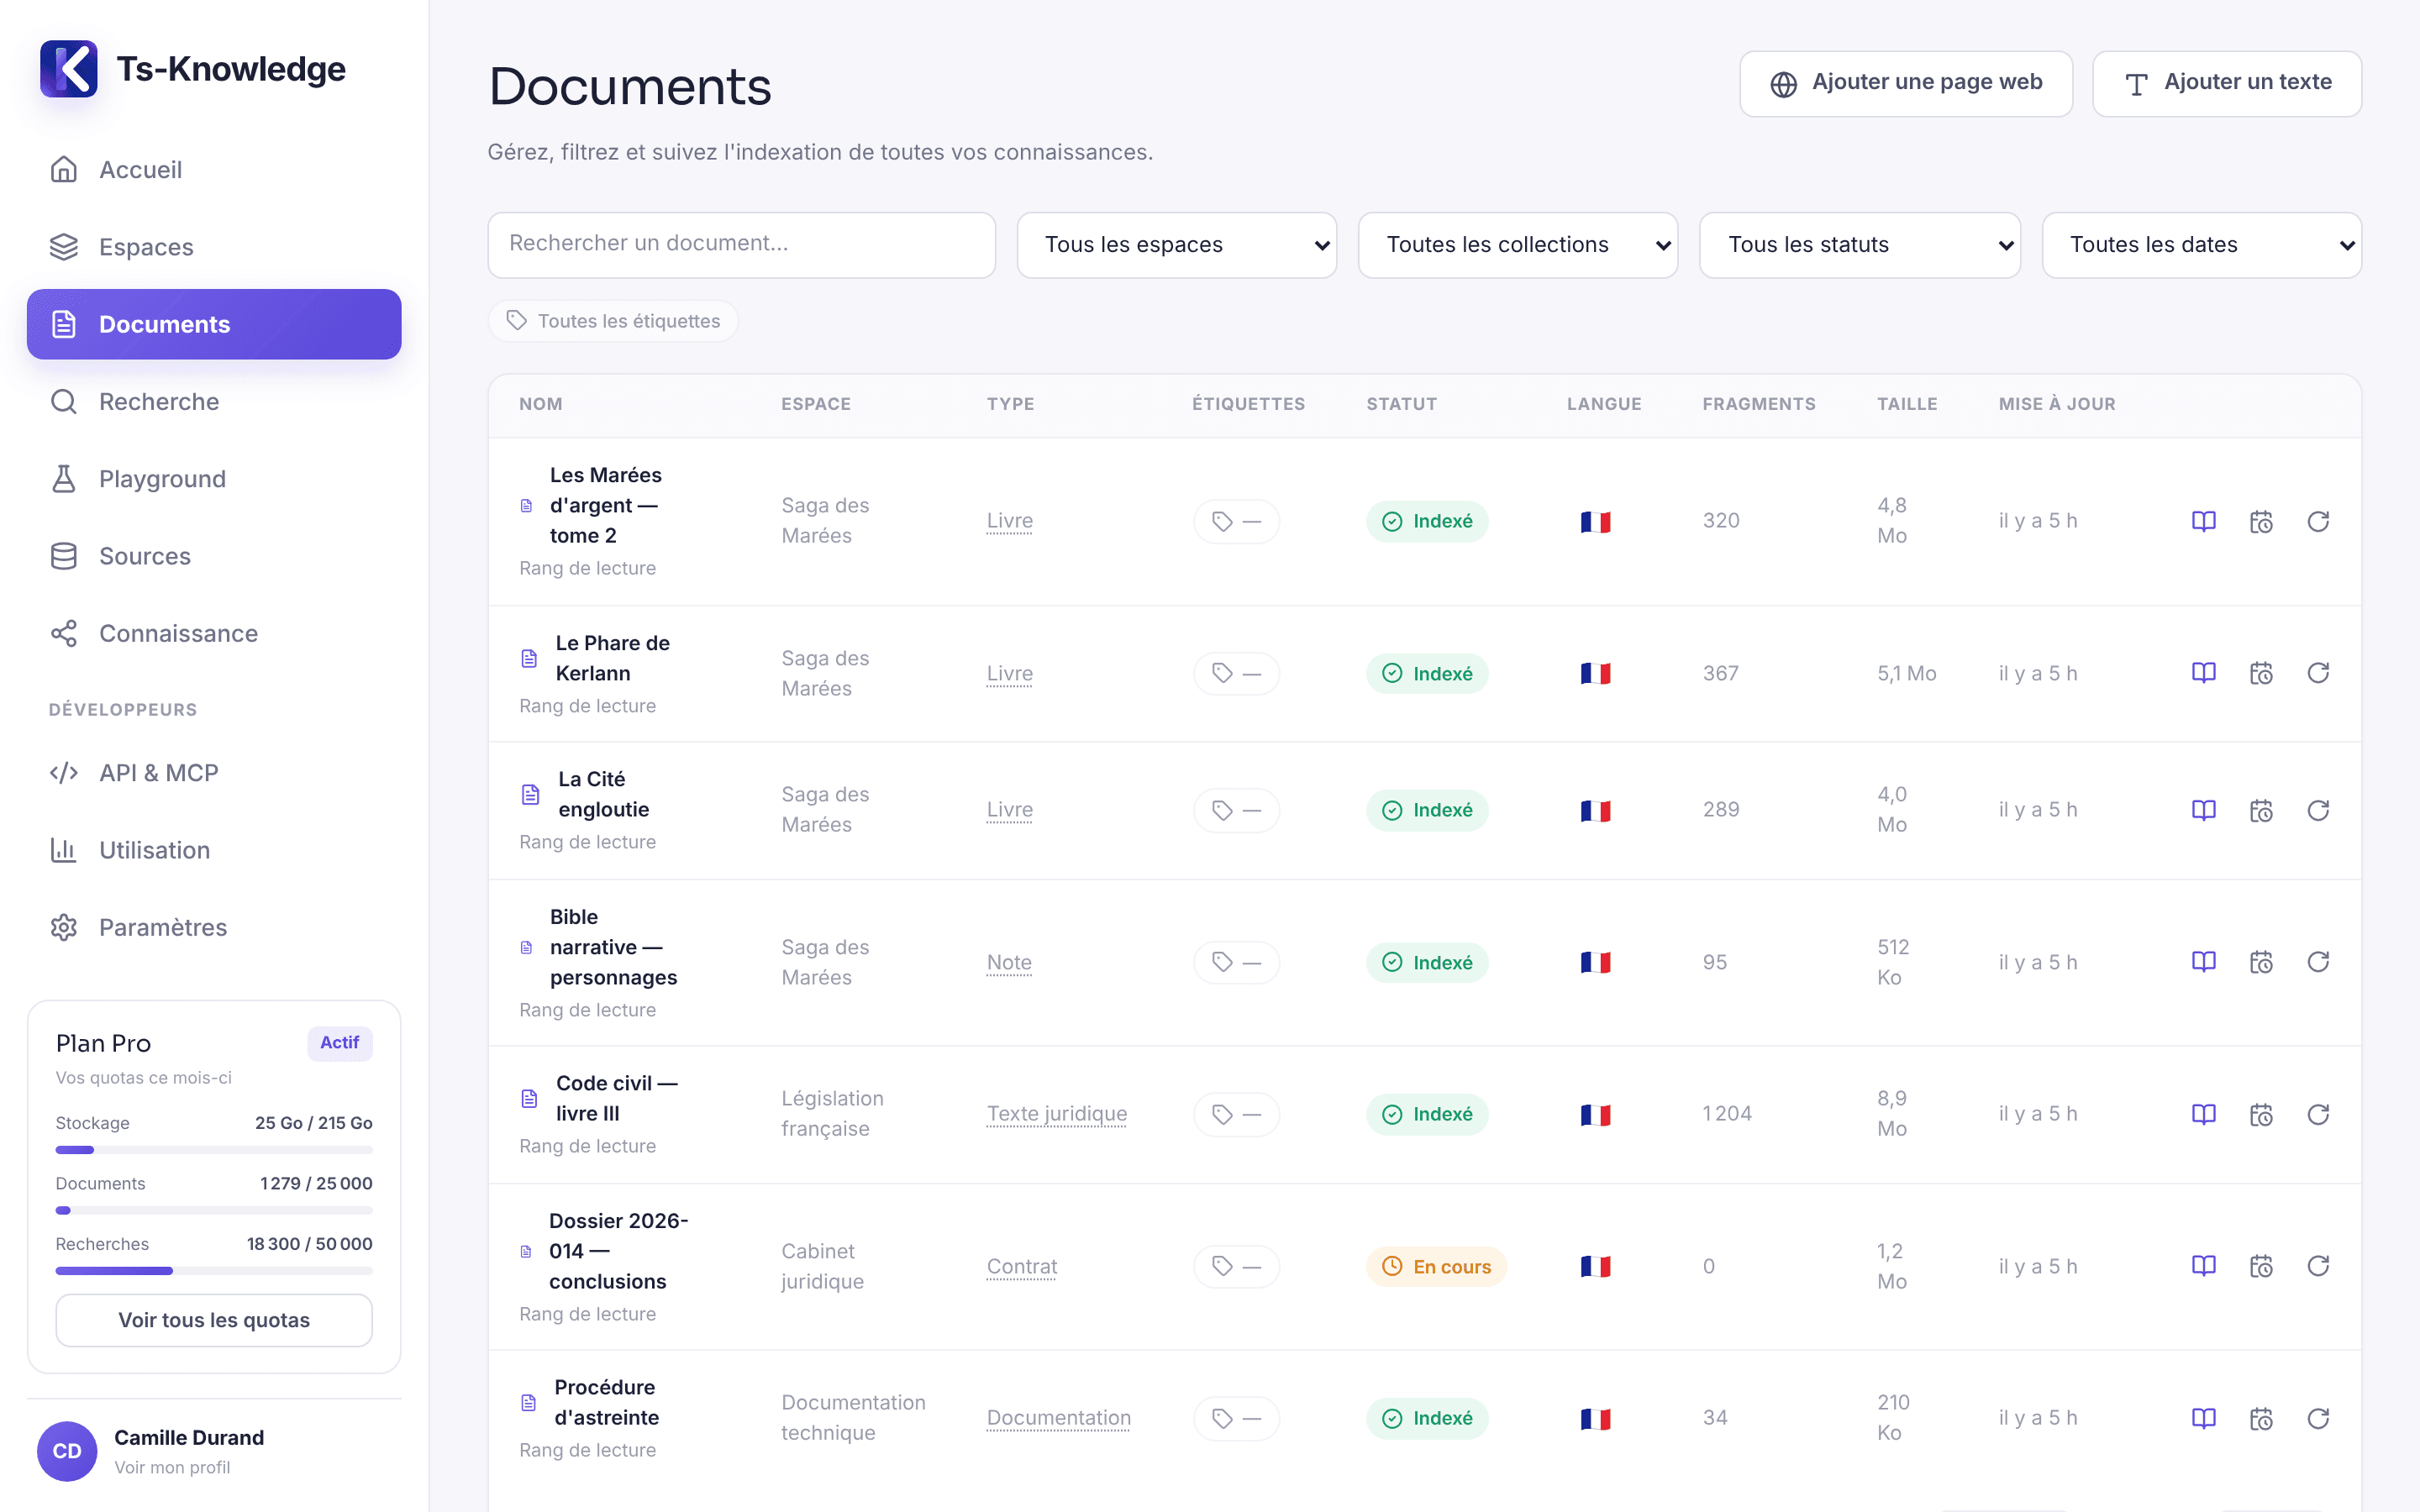
Fichiers, texte collé, site web ou source synchronisée. L'indexation se fait en arrière-plan.
Posez vos vraies questions dans le Playground : extraits, scores et sources.
Facultatif : entités, faits, relations, chronologie et flocon, tirés de vos documents.
Une clé, une adresse MCP, et votre agent travaille sur vos connaissances.
Chaque requête est filtrée par compte et par espace côté serveur — recherche, fiches et preuves comprises. Un identifiant fourni par un client n'ouvre jamais un accès à lui seul.
Les clés des fournisseurs d'IA sont chiffrées au repos, essayées avant d'être acceptées, et ne ressortent jamais de l'API.
Stockage, documents, recherches : les plafonds de votre offre sont affichés en permanence, pas découverts au moment d'être bloqué.
Les mêmes trois couches, dans des métiers très différents. Chaque cas d'usage montre, exemples à l'appui, ce que la recherche, la connaissance structurée et le flocon y changent — et comment votre agent s'en sert.
Créez un espace, déposez quelques documents, posez votre première question — puis donnez la même clé à votre agent.